KI verändert den Arbeitsalltag schneller, als Unternehmen ihre Freigabeprozesse anpassen können.
Während die IT noch prüft, welche Anwendungen erlaubt sind und welche Daten verarbeitet werden dürfen, nutzen die Mitarbeiter frei verfügbare Tools. So entsteht Schatten-KI. Das eigentliche Problem ist jedoch nicht die Eigeninitiative der Beschäftigten. Es ist die Lücke zwischen dem Tempo, das KI verspricht, und dem Tempo, mit dem Governance versucht, Schritt zu halten. Unternehmen brauchen keine noch strengeren Richtlinien für KI, sondern einen Prozess, der schneller und einfacher ist.
Ein Mitarbeiter lädt einen Vertragsentwurf in ChatGPT hoch, weil das schneller geht, als ihn selbst zu lesen. Ein firmeneigener Copilot-Assistent wiederum durchsucht alles, worauf der jeweilige Account Zugriff hat. Diese Situation kennt wahrscheinlich jedes Unternehmen. Das Problem liegt allerdings weniger an der KI selbst als an gewachsenen IT-Umgebungen mit weitreichenden Zugriffsrechten. E-Mails, PDFs, Präsentationen und Verträge liegen in Fileshares, SharePoint, Teams oder Object Storage ab, die eigentlich nie für die Arbeit mit KI vorgesehen waren. Folglich kann es passieren, dass ein Assistent automatisiert auf eine HR-Ablage zugreift, die ursprünglich nur für einen eingeschränkten Personenkreis gedacht war. Sobald KI im Spiel ist, werden aus historisch gewachsenen Berechtigungsstrukturen potenzielle Datenrisiken.
Schatten-KI lässt sich nicht wegregeln
Der entscheidende Punkt ist: Eine KI mit Informationen zu füttern, bedeutet im Grunde, ihr einen Generalschlüssel für Datenbestände zu geben, deren Inhalt niemand genau kennt. Es ist fahrlässig, darauf zu hoffen, dass sich dahinter nichts Kritisches verbirgt. Bevor Unternehmen also ein Modell einsetzen, müssen sie zunächst klären, welche Informationen dieses Modell überhaupt sehen darf.
Die Versuchung, das Problem mit Richtlinien zu lösen, ist groß. Doch ein Verbot konkurriert mit einem sehr einfachen Argument: Zeit. Wer für eine Aufgabe in wenigen Minuten ein Ergebnis mit einem frei zugänglichen KI-Tool erhält, wird kaum freiwillig einen Prozess nutzen, der erst nach mehreren Freigabestufen eine vergleichbare Möglichkeit eröffnet. Eine internationale Aptean-Studie aus dem Sommer 2026 zeigt, dass Mitarbeiter längst eigene Wege gehen: 40 Prozent der Befragten verwenden KI-Tools ohne formale Genehmigung. Oft fehlt schlicht eine freigegebene Alternative oder sie steht nicht schnell genug bereit1. Damit entsteht ein Wettlauf, den klassische Governance kaum gewinnen kann. Die Lösung liegt nämlich nicht in möglichst vielen Verboten. Unternehmen brauchen vielmehr einen offiziellen Weg, der die gleiche Geschwindigkeit bietet wie die Schatten-KI, aber mit kontrollierten Daten.
AI Collections bündeln das Unternehmenswissen
Genau hier kommen die sogenannten AI Collections ins Spiel. Dahinter steht ein einfacher Perspektivwechsel: Nicht die KI erhält pauschal Zugriff auf den Datenbestand, sondern die Daten werden für einen konkreten KI-Zweck in einen definierten, vertrauenswürdigen Raum überführt. Sinnvoll ist dabei ein abgestufter Ansatz: Eine unternehmensweite Collection kann beispielsweise zunächst einmal personenbezogene, vertrauliche oder regulatorisch heikle Inhalte konsequent entfernen oder maskieren. Auf einer zweiten Ebene kann dann eine speziell auf eine Abteilung zugeschnittene Collection entstehen. Ein fachlicher Owner definiert und pflegt die Freigaberegeln dafür und entscheidet, welche Inhalte für bestimmte KI-Anwendungen geeignet sind. So entsteht kein großer, einheitlicher Datenpool für sämtliche Anwendungsfälle, sondern ein System abgestufter Vertrauensbereiche.
Eine dritte Ebene wäre schließlich für persönliche, wenig sensible Daten denkbar. Diese könnten automatisiert geprüft und im Self-Service freigegeben werden. Damit ließe sich der Zeitvorteil der Schatten-KI aushebeln: Wer unkritische Informationen innerhalb weniger Minuten sicher für eine KI-Anwendung zur Verfügung hat, hat keinen Grund mehr, den Umweg über ein nicht freigegebenes Tool zu nehmen. Inwieweit sich diese dritte Ebene automatisieren lässt, wird sich allerdings erst in der Praxis zeigen.
Ein pragmatischer Ansatz ist der einfachste Weg
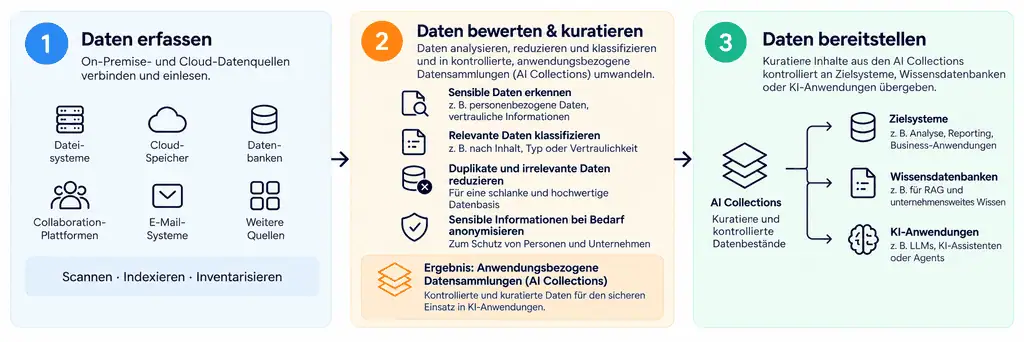
Der Weg zu AI Collections mit kuratiertem, klassifizierten Unternehmenswissen folgt unabhängig von der jeweiligen Freigabestufe einem klaren Muster. Zunächst werden Dateisysteme, Cloud-Speicher, Datenbanken, Collaboration-Plattformen und E-Mail-Systeme verbunden, gescannt und inventarisiert. Dadurch erhalten Unternehmen erstmals einen Überblick darüber, welche Daten tatsächlich vorhanden sind. Anschließend werden die Inhalte bewertet und kuratiert: Sensible Informationen werden erkannt, relevante Inhalte klassifiziert, Duplikate reduziert und Daten bei Bedarf anonymisiert. Das Ergebnis sind kontrollierte AI Collections, die gezielt an Wissensdatenbanken, Zielsysteme oder KI-Anwendungen weitergegeben werden können.
Dafür ist kein umfassendes Governance-Projekt nötig – Unternehmen können beziehungsweisen sollten vielmehr klein anfangen. Bereits ein erster Scan der vorhandenen, unstrukturierten Datenlandschaft liefert einen erheblichen Mehrwert: Firmen sehen erstmals, wo welche Daten liegen, wie viele davon sensibel oder veraltet sind und wo die größten Risiken schlummern. Auf dieser Grundlage lassen sich einzelne Collections und Anwendungsfälle priorisieren. Anstatt gleich ein umfassendes Governance-Projekt aufzusetzen, bei dem zunächst jede denkbare Ausnahme geregelt werden muss, können Unternehmen Schritt für Schritt die nächsten Freigabestufen entwickeln.
Eine Collection ist nur so gut wie ihr letzter Scan
Eine solche Collection entsteht jedoch nicht, indem die IT einmalig einen Ordner aufräumt. Datenbestände verändern sich ständig – es kommen neue Dokumente hinzu, Berechtigungen wechseln, Projekte enden oder Informationen verlieren ihre Gültigkeit. Automatisierte Re-Scans erkennen solche Veränderungen und stoßen eine erneute Bewertung an. Regeln können dabei auf allgemeine Vorgaben wie die DSGVO oder auf branchenspezifische Anforderungen für Gesundheits- und Zahlungsdaten zugeschnitten werden. So wird aus einem einmaligen Bereinigungsprojekt ein kontinuierlicher Klassifizierungsprozess. Auch mit Blick auf neue Regulatorik wird ein solcher Ansatz immer wichtiger. Am 2. August 2026 sind die meisten zentralen Vorschriften des EU AI Act wirksam geworden, mit möglichen Bußgeldern in Millionenhöhe. Wer im Ernstfall nachweisen muss, welche Daten in ein KI-System eingeflossen sind und welche bewusst ausgeschlossen wurden, profitiert von einer laufenden und dokumentierten Prozesskette.
Dabei reicht es nicht aus, Daten einfach lokal zu verarbeiten. Datensouveränität bedeutet, dass das Unternehmen die Regeln dafür selbst bestimmt und diese Entscheidungen nachvollziehen kann. Ein oft übersehener Punkt ist, dass manche Lösungen bereits externe Services oder Modelle zur Vorbereitung der Daten für den KI-Einsatz nutzen. Dadurch können sensible Inhalte nach außen gelangen, bevor die eigentliche KI-Anwendung überhaupt zum Einsatz kommt. Lokal ausgeführte Klassifizierungsregeln oder -modelle vermeiden auch dieses Risiko.
Fazit: Die KI braucht keinen höheren Zaun
Schatten-KI verschwindet nicht, weil Unternehmen sie verbieten. Sie verschwindet, wenn der freigegebene Weg attraktiver ist. Dafür braucht es abgestufte AI Collections, kontinuierliche Klassifizierung und einen Einstieg, der einfach genug ist, um sofort zu beginnen. Wer KI aus dem Schatten holen will, muss deshalb nicht nur Grenzen definieren. Er muss einen besseren Weg aufzeigen – und zwar einen, den Mitarbeitende freiwillig wählen.