Nicht das Modell entscheidet darüber, ob KI-Agenten wirtschaftlich arbeiten, sondern das Wissen, auf das sie zugreifen können. Wie Knowledge Layer, Context Graph und Agent Memory den Tokenverbrauch senken und Agenten im Unternehmensalltag zuverlässiger machen.
Sobald KI-Agenten in den produktiven Betrieb gehen, wird Effizienz zur Kostenfrage: Budgets werden überschritten, Tokenkontingente aufgebraucht und Rollouts geraten unter Druck. Nutzungslimits, Modell-Routing oder Kosten-Dashboards greifen jedoch zu kurz, wenn die Ursachen in der Architektur liegen. Vier typische Fehler zeigen, wo Unternehmen bei ihrer Agentic-AI-Infrastruktur nachjustieren können.
Der Kostendruck rund um generative KI ist längst im Unternehmensalltag angekommen. Laut McKinsey überziehen 93 Prozent der befragten Unternehmen ihre KI-Budgets – knapp die Hälfte sogar um bis zu 30 Prozent. Wo Tokenpools bereits nach wenigen Monaten aufgebraucht sind, folgt die Notbremse. Selbst große Unternehmen versuchen, aus dem hohen Verbrauch wieder kalkulierbare Kosten zu machen. Uber etwa begrenzte die Ausgaben für agentische Coding-Tools auf 1.500 US-Dollar pro Mitarbeiter und Monat. Walmart und Cisco haben Beschränkungen für die KI-Nutzung eingeführt. Und auch Amazon und Meta sind von internen Rankings zur KI-Nutzung wieder abgerückt.
Hoher Token-Verbrauch gilt nicht länger automatisch als Zeichen hoher Produktivität (Stichwort: Tokenmaxxing). Wenn Agenten sich durch unaufgeräumte Datensilos arbeiten, irrelevante Informationen analysieren, Arbeitsschritte wiederholen oder bei jeder Anfrage erneut mit der Suche beginnen, kostet das Zeit und Geld. Wie groß der Unterschied sein kann, verdeutlicht eine Studie zu agentischen Coding: Bei derselben Aufgabe schwankte der Tokenverbrauch zwischen einzelnen Durchläufen um bis das 30-fache. Zusätzliche Reasoning-Schritte, Tool-Aufrufe und schlecht strukturierter Kontext treiben den Verbrauch weiter in die Höhe.
Vier typische Fehler bei Agentic AI
AI-FinOps, eingebettete KI-Governance, klare Verantwortlichkeiten und Richtlinien schaffen Transparenz und Kontrolle im KI-Betrieb. Sie lösen jedoch nicht die Ursachen ineffizient arbeitender Agenten. Denn ob Agentic AI im Unternehmensalltag zuverlässig und wirtschaftlich funktioniert, entscheidet sich wesentlich in der Daten- und Kontextarchitektur. Vier typische Fehler machen deutlich, wo Unternehmen nachjustieren können.
Fehler 1: Dem Agenten fehlt der geschäftliche Kontext
Ein KI-Agent im Kundenservice kann auf CRM-Daten, Produktinformationen, Vertragsbedingungen und interne Richtlinien zugreifen – und trotzdem an einer einfachen Reklamation scheitern. Denn Datenzugriff allein reicht nicht. Der Agent muss auch verstehen, wie Kunde, Produkt, Vertrag und Servicefall zusammenhängen, welche Regel im konkreten Fall gilt und wer für eine Entscheidung zuständig ist. Oder anders gesagt: er muss das Geschäft kennen.
Unternehmenswissen ist weit mehr als das, was in Handbüchern, Datenbanken oder Prozessbeschreibungen festgehalten ist. Es ist aus Erfahrung entstanden und tief in den Mitarbeitenden, Routinen, Beziehungen und der Unternehmenskultur verankert. Wie lässt sich diese gemeinsame Wissensbasis also abbilden, sodass KI-Agenten sie nutzen können?
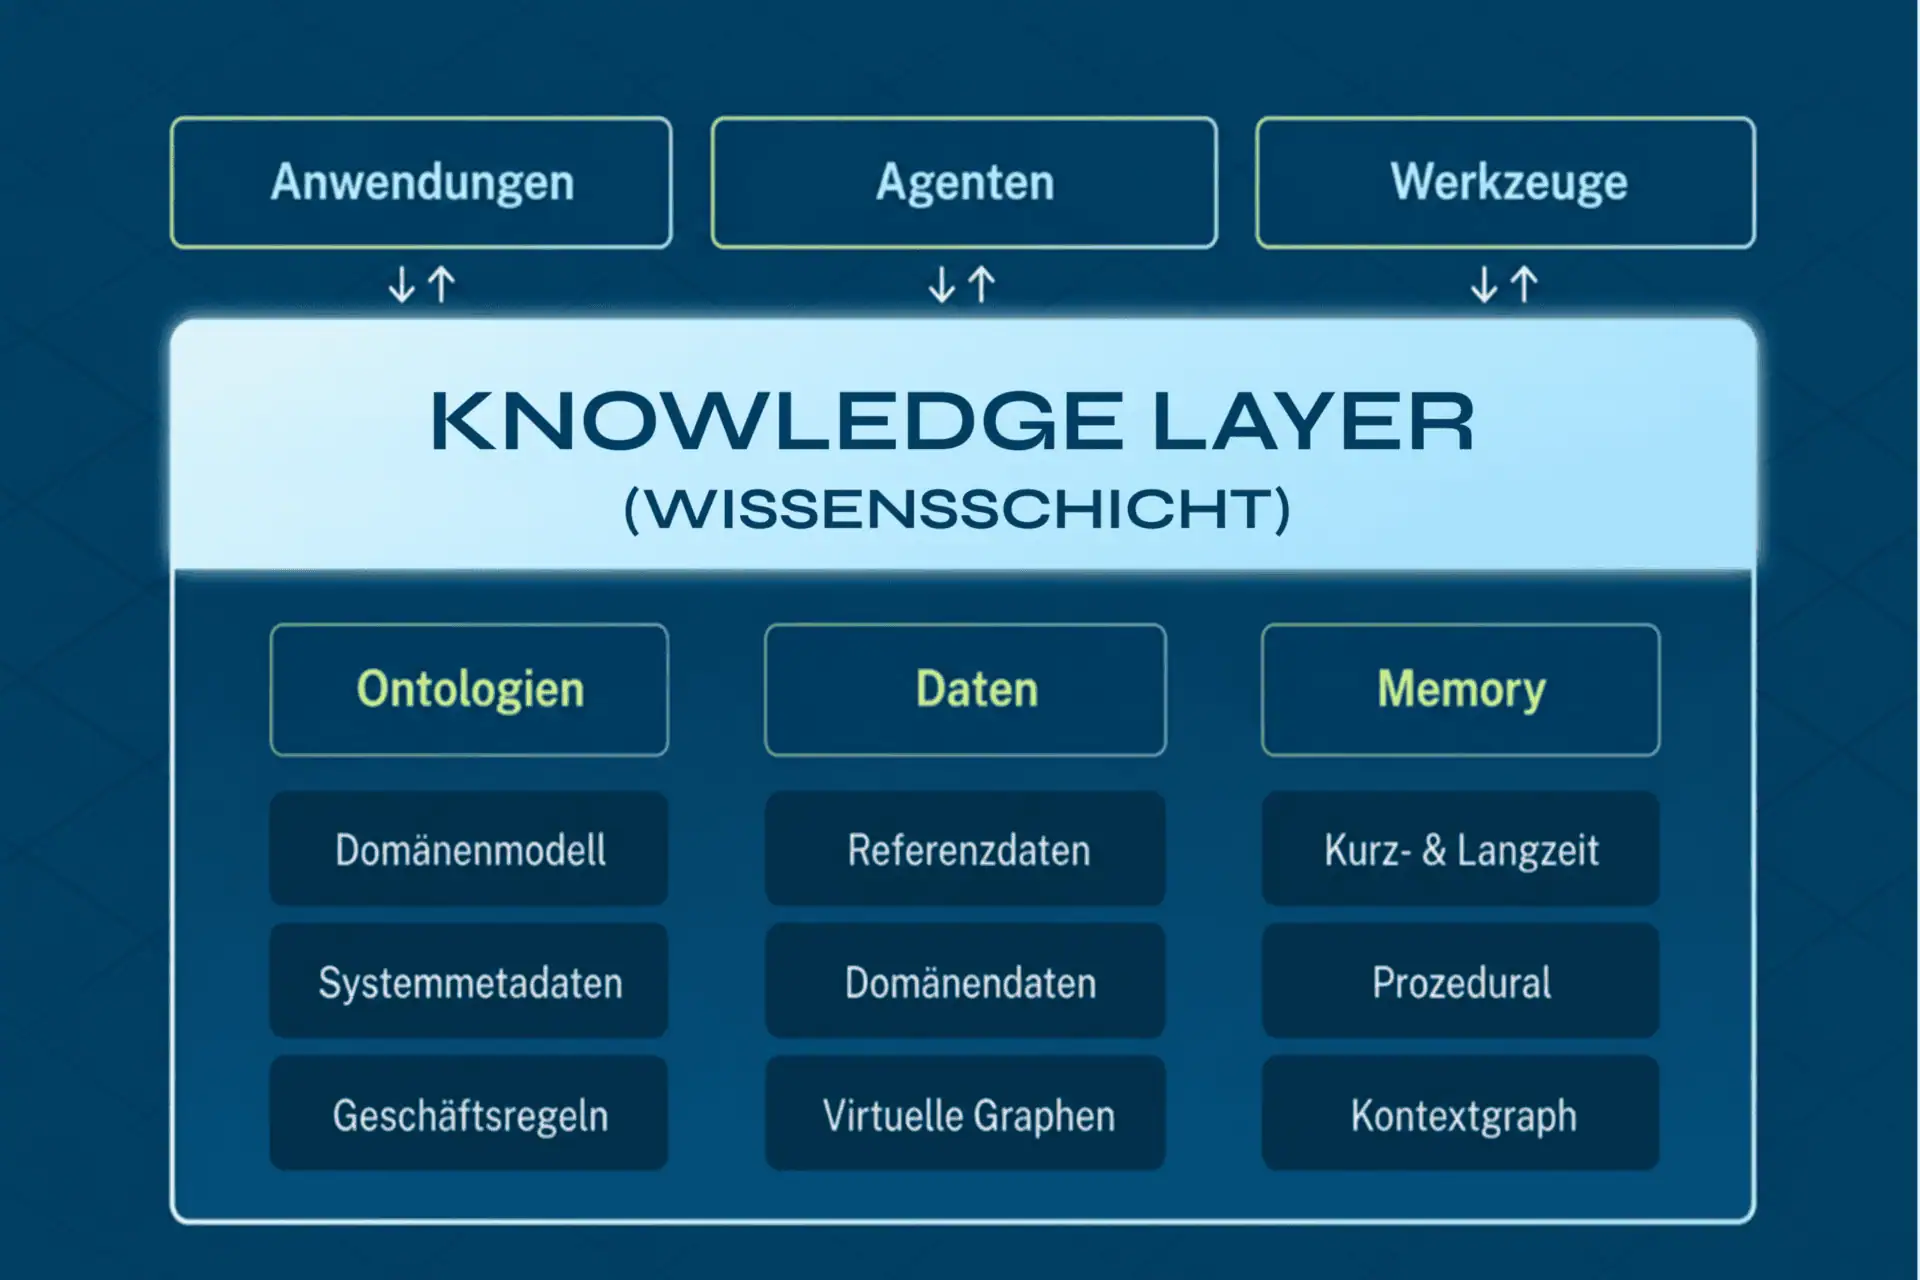
Hier setzt die Knowledge Layer an. Sie stellt eine übergeordnete Data Framework für KI-Systeme dar und verbindet dafür drei Komponenten: Eine Ontologie bildet ab, wie das Unternehmen arbeitet – etwa Fachbegriffe, Geschäftsobjekte, Rollen, Prozesse, Systeme und Datenbestände. Unternehmensdaten füllen dieses Modell mit konkreten Inhalten, zum Beispiel Referenz-, Stamm- und Transaktionsdaten. Die Gedächtniskomponente (Memory) ermöglicht der KI, Informationen über Zeit hinweg zu speichern, wieder abzurufen und für weitere Aufgaben zu nutzen.
Für den eingangs beschriebenen Kundenservice-Agenten bedeutet das konkret: Er erhält eine 360-Grad-Sicht auf den Kunden, kann relevante Zusammenhänge und den jeweiligen Kontext einordnen. Dadurch weiß er, ob die Reklamation unter die geltende Garantie fällt oder welche Kulanzregel greift.
Fehler 2: Dem Agenten fehlt der Kontext früherer Entscheidungen
Kommt eine Reklamation im Kundenservice an, zählen nicht nur aktuelle Daten, sondern auch der Blick in die Vergangenheit. Welche Entscheidungen wurden in vergleichbaren Fällen bereits getroffen? Welche Gründe gab es dafür? Häufen sich bei dem reklamierten Produkt etwa die Reklamationsfälle?
Innerhalb der Knowledge Layer übernimmt der Context Graph diese Aufgabe. Als Erweiterung eines Knowledge Graphs bündelt er die Informationen, die für Entscheidungen innerhalb eines bestimmten Anwendungsbereichs erforderlich sind. Dazu verbindet er die Wissensbasis mit früheren Entscheidungen, Reasoning-Pfade, Ergebnissen und Begründungszusammenhängen. Ein Agent erkennt dadurch nicht nur, wo er steht, sondern auch, warum dieser Zustand entstanden ist und welcher Schritt als Nächstes sinnvoll ist.
Für den einzelnen Arbeitsschritt ruft ein Agent dabei nur den relevanten Ausschnitt des Graphen auf. Das begrenzt die Datenmenge im Kontextfenster und reduziert die Zahl der nötigen Suchvorgänge. Damit sieht der Agent im Kundenservice nicht nur, dass einem Kunden bei einer früheren Reklamation Kulanz gewährt wurde. Dank des Context Graphs versteht er auch, warum.
Fehler 3: Der Agent vergisst, wo er im Prozess steht
LLMs besitzen in der Regel kein dauerhaftes Gedächtnis: Sie „vergessen“, verlieren sich in Teilaufgaben und Detailfragen oder kommen nur über Umwege ans Ziel (oder eben nicht). Im Kundenservice wird das schnell zum Problem. Hat der Agent bei einer Reklamation bereits Kundendaten geprüft, Garantiebedingungen abgeglichen und eine Rückfrage gestellt, muss er diesen Arbeitsstand auch nach einer Unterbrechung noch kennen. Sonst wiederholt er bereits erledigte Schritte oder beginnt mit der Bearbeitung von vorn.
Das Agentengedächtnis (Agent Memory) bezeichnet die Fähigkeit eines KI-Agenten, Informationen über längere Zeit zu speichern, abzurufen und für weitere Entscheidungen oder Aktionen zu nutzen. Besonders wichtig ist dabei das Kurzzeitgedächtnis (Short-Term Memory). Es speichert den aktuellen Arbeitskontext und hält den Agenten auf Kurs: Was ist das Ziel? Woran wird gerade gearbeitet? Welcher Agent übernimmt welche Teilaufgabe? Und was wurde bereits erledigt?
Wie der Context Graph ist auch das Agentengedächtnis Teil der Knowledge Layer, wobei das Kurzzeitgedächtnis den Fokus auf den Arbeitsstand und den bisherigen Verlauf des Agenten legt. Im Kundenservice hält es einen Fall auch dann auf Kurs, wenn Aufgaben unterbrochen, weitergereicht oder von mehreren Agenten bearbeitet werden: Antwortet der Kunde etwa zwei Tage später mit dem noch fehlenden Kaufbeleg, weiß der Agent, was bereits geprüft wurde und welcher Schritt als Nächstes ansteht.
Fehler 4: Der Agent ist mit Wissen und Regeln überladen
Die Wissensinfrastruktur aus Knowledge Layer, Context Graph und Agent Memory schafft die Voraussetzung dafür, Agenten möglichst schlank zu halten. Denn wenn ein Kundenservice-Agent etwa Garantiebedingungen, Kulanzregeln, Zugriffsrechte und Eskalationswege bei jedem Schritt in seiner eigenen Logik mitführt, wird er unnötig schwerfällig. Gerade bei mehrstufigen Aufgaben ist das problematisch, weil sich Regeln, Informationen und Entscheidungskontext im Verlauf ändern können.
Sogenannte Thin Agents greifen deshalb nur dann auf Unternehmenswissen, Geschäftsregeln, Zugriffsrechte und Entscheidungskontext zu, wenn sie diese auch brauchen. Damit bleibt der Fokus auf den eigentlichen Aufgaben: Nutzerabsicht verstehen, nächste Schritte planen, Aktionen ausführen. Es entstehen kürzere Systemprompts, weniger doppelte Logik und geringerer Pflegeaufwand. Regeln und Wissen werden zentral gepflegt – das reduziert Redundanz und verhindert, dass Agenten mit der Zeit auf unterschiedlichen Wissensständen arbeiten.
Dass sich diese Art von verknüpftem Wissen auch messbar auf die Qualität von KI-Antworten auswirkt, zeigt eine Studie des National Innovation Centre for Data (NICD). Dafür ließen die Forschenden einen graphgestützten und einen rein vektorbasierten RAG (Retrieval-Augmented Generation)-Ansatz 510 komplexe Fragen beantworten. Das Ergebnis: Der graphgestützte Ansatz schnitt deutlich besser ab. Der Truthfulness-Score lag rund 80 Prozent höher, gleichzeitig stieg der Anteil beantworteter Fragen von knapp 29 auf mehr als 65 Prozent. Der Grund: Das System kann gezielt relevante Abschnitte und Zusammenhänge heranziehen, statt immer wieder ganze Dokumente zu verarbeiten. Gleichzeitig lassen sich die verfügbaren Tokens deutlich effizienter einsetzen.
Die vier Fehler veranschaulichen: Produktive Agenten müssen das Geschäft verstehen, frühere Entscheidungen im Kontext einordnen, ihren Arbeitsstand behalten und gezielt auf Wissen und Regeln zugreifen können. Dafür braucht es mehr als ein leistungsfähiges Modell. Der eigentliche Differenzierungsfaktor ist das eigene Unternehmenswissen – sauber strukturiert und kontrolliert bereitgestellt.