Eine Inference Factory ist ein integrierter Stack, der trainierte KI-Modelle im eigenen Rechenzentrum produktiv ausführt. Scality hat am 8. Oktober 2026 eine solche Lösung vorgestellt. Der Beitrag erklärt, was hinter dem Begriff steckt, wie die Technik funktioniert, welche Wettbewerber es gibt und was Gartner, Forrester und IDC dazu sagen.
Scality AI Inference Factory
Inference Factory: KI-Inferenz im eigenen Rechenzentrum betreiben
Was ist eine Inference Factory?
Der Begriff Inference Factory ist kein genormter Standard, sondern ein Marketingbegriff, den Anbieter unterschiedlich füllen. Er geht auf die „AI Factory“ zurück, die NVIDIA geprägt hat. Laut NVIDIA-Glossar ist das eine spezialisierte Recheninfrastruktur, die den gesamten KI-Lebenszyklus abdeckt, von der Datenaufnahme über Training und Feintuning bis zur Inferenz mit hohem Volumen. Das Produkt sei Intelligenz, gemessen am Token-Durchsatz.
Eine Inference Factory konzentriert sich auf den letzten Schritt. KI-Inferenz bezeichnet die Phase nach dem Training, in der ein Modell Eingaben verarbeitet und Ausgaben erzeugt, so beschreibt es NVIDIA. Eine Inference Factory bündelt dafür vier Bausteine: Modelle, eine Serving-Schicht, die Anfragen auf GPUs verteilt, eine Steuerungsebene für Zugriff, Abrechnung und Planung sowie einen schnellen Speicher für Modelle, Daten und Zwischenstände. Entscheidend ist der Gedanke der Fabrik: Der Stack wird als geprüftes Gesamtsystem geliefert und gewartet, statt dass Unternehmen Einzelteile selbst zusammenbauen.
Warum Inferenz jetzt in den Mittelpunkt rückt
Die Zahlen der Analysten zeigen die Verschiebung. Gartner rechnet für 2026 mit weltweit 42,3 Milliarden US-Dollar Ausgaben für KI-optimierte Infrastructure-as-a-Service, ein Plus von 96 Prozent. Davon entfallen laut Gartner, berichtet von it-daily.net, 23,3 Milliarden Dollar auf Inferenz und 19 Milliarden auf Training. Der Inferenzanteil liege 2026 bei 55 Prozent und soll 2027 auf 59 Prozent steigen. Als Treiber nennt Gartner unter anderem Agentic AI, weil mehrstufige, autonome Abläufe die Rechenlast erhöhen.
Für Unternehmen, die KI produktiv einsetzen, entstehen daraus drei Fragen. Erstens die Kosten: Wer pro Token abrechnet, zahlt mit jedem zusätzlichen Workflow mehr, und die Ausgaben lassen sich schwer deckeln. Zweitens die Kontrolle: Cloud-Anbieter können Modellversionen und Quantisierung ändern, was darauf aufbauende Abläufe beeinflusst. Drittens die Datensouveränität: Wo werden Prompts, Dokumente und Code verarbeitet, und welcher Rechtsordnung unterliegen sie? Diese Argumente führt Scality in seiner Mitteilung an. Sie decken sich mit Umfragen: Laut dem Private Cloud Outlook 2026 von Broadcom planen oder betreiben 56 Prozent der befragten Unternehmen produktive KI-Inferenz in der Private Cloud, der Anteil der Public Cloud als Hauptumgebung sank innerhalb eines Jahres von 56 auf 41 Prozent. Befragt wurden 1.800 IT-Verantwortliche. Da Broadcom selbst Private-Cloud-Software anbietet, sollte man die Studie als interessengeleitet lesen.
Technik: Prefill, Decode und KV-Cache
Um zu verstehen, was eine Inference Factory leistet, hilft ein Blick auf den Ablauf einer Anfrage. Er besteht aus zwei Phasen. Beim Prefill verarbeitet das Modell den gesamten Prompt. Das ist rechenintensiv und bestimmt die Zeit bis zum ersten Token. Beim Decode erzeugt das Modell die Antwort Token für Token. Diese Phase ist laut den Folien zur DistServe-Studie speichergebunden.
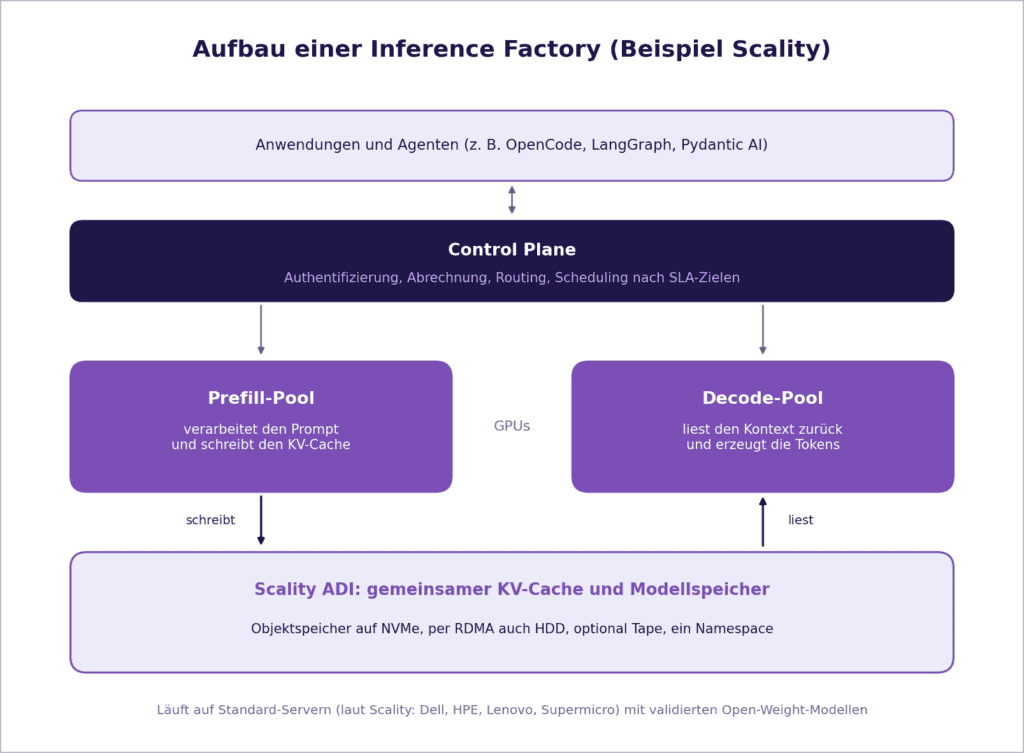
Während beider Phasen baut das Modell einen Zwischenspeicher auf, den Key-Value-Cache, kurz KV-Cache. Er enthält den bereits verarbeiteten Kontext. Bei langen Dokumenten, Reasoning-Modellen und Agenten wächst er schnell über den begrenzten High-Bandwidth Memory (HBM) der GPU hinaus. Geht Kontext verloren, muss die GPU ihn erneut berechnen. Genau hier setzt die Disaggregation an: Prefill und Decode laufen auf getrennten GPU-Pools, und ein gemeinsamer Cache hält den Kontext vor.
Die Idee ist wissenschaftlich gut belegt. Die auf der Konferenz OSDI 2024 vorgestellte Studie DistServe trennt Prefill und Decode und bediente damit bis zu 7,4-mal mehr Anfragen oder erfüllte 12,6-mal engere Latenzziele als Vergleichssysteme, bei mehr als 90 Prozent der Anfragen innerhalb der Vorgaben. Das Serving-System Mooncake von Moonshot AI ergänzt einen verteilten KV-Cache. Laut den Autoren kann der Dienst Kimi dadurch unter realer Last 75 Prozent mehr Anfragen bearbeiten. Beide Ergebnisse stammen aus Forschungs- und Betriebsumgebungen der Autoren und lassen sich nicht ohne Weiteres auf jedes Unternehmen übertragen.
Die Scality AI Inference Factory im Detail
Scality, bekannt für Objektspeicher, vermarktet die AI Inference Factory als unterstützte Alternative zu Cloud-KI-Diensten für Unternehmen, Behörden und Neo-Cloud-Anbieter. Laut Mitteilung besteht der Stack aus vier Teilen:
- validierten Open-Weight-Modellen, die als Teil des Stacks gepflegt werden,
- disaggregiertem Inference Serving, bei dem Prefill und Decode getrennt skalieren,
- einer Control Plane für Authentifizierung, Abrechnung, Routing und Scheduling nach SLA-Zielen,
- der Scality AI Data Infrastructure (ADI) als Speicher für Modelle, Unternehmensdaten und Inferenz-Zustand.
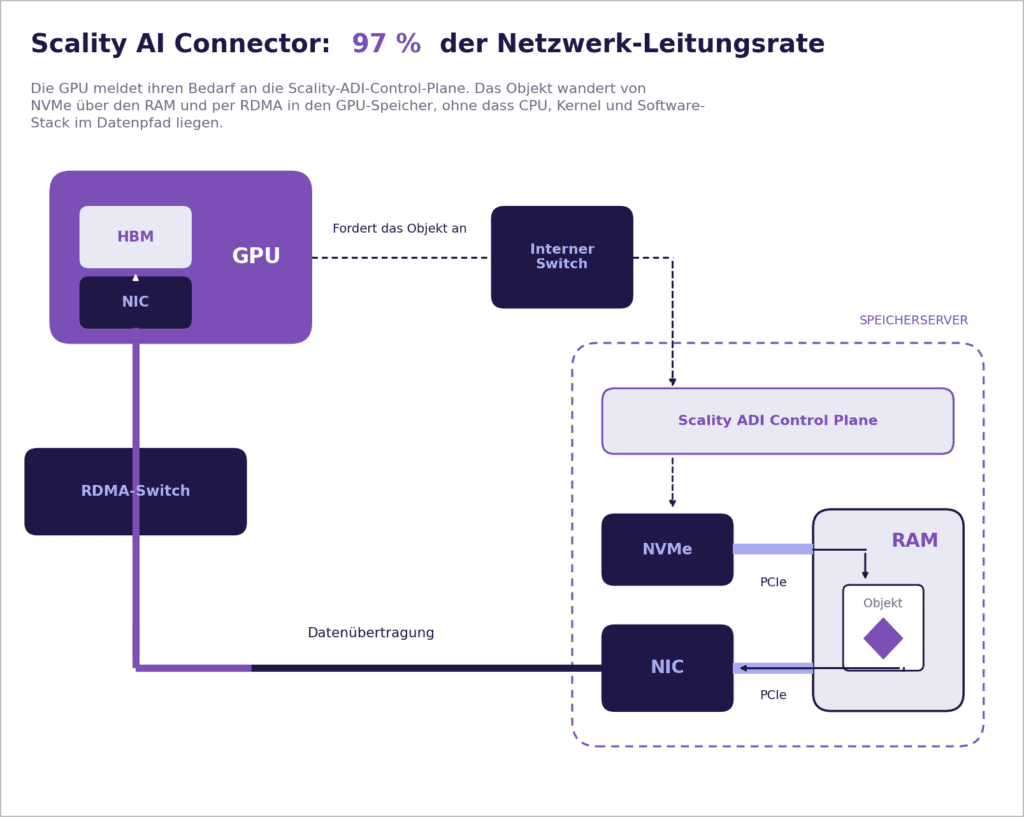
Die ADI dient als gemeinsame Cache-Schicht. Sie erweitert den KV-Cache über den GPU-Speicher hinaus und liefert nach Herstellerangaben einen Cache im Multi-Petabyte-Maßstab, auf den GPUs mit einer Latenz in der Größenordnung des GPU-Speichers zugreifen. Ein Namespace verteilt Daten über TLC-Flash, HDD und optional Tape. Der Datentransfer läuft per RDMA direkt zwischen Speicherserver und GPU.
Scality nennt aus eigenen Tests mehrere Messwerte. Es handelt sich um Herstellerangaben, unabhängige Benchmarks liegen nicht vor:
- Das Laden von Gemma-3 27B dauert 1,9 Sekunden und ist damit nahezu zehnmal schneller als von lokalem NVMe.
- Das Wiederherstellen eines Kontexts mit 14.000 Token aus der ADI ergibt eine Time-to-First-Token von 166 Millisekunden, 83 Millisekunden langsamer als aus dem HBM.
- Der Abruf des KV-Caches ist bei 14.000 Token 14-mal und bei 439.000 Token bis zu 72-mal schneller als eine Neuberechnung.
- Ein KV-Cache, der rund 80-mal größer ist als der Speicher einer GPU, hält bis zu 1.000 parallele Sitzungen vor, ohne neu zu rechnen.
- Zwischen GPUs und Storage werden 97 Prozent der Netzwerkbandbreite erreicht.
Offen ist laut Scality auch die Softwarebasis. Jede ausgelieferte Komponente werde als Open Code bereitgestellt, Kunden könnten also nachvollziehen, wie Inferenz-Zustände gespeichert und übertragen werden, und Beiträge zur Prüfung einreichen. Kompatibel ist der Stack mit Frameworks wie OpenCode, Hermes, Goose, LangGraph und Pydantic AI. Unterstützt werden validierte Modelle von Mistral, Gemma, gpt-oss, Qwen, Kimi, GLM und DeepSeek auf Standard-Servern von Dell, HPE, Lenovo und Supermicro. Verfügbar ist die Lösung als Softwarelizenz oder als vollständig gemanagter Service. Eine Referenzarchitektur zeigte Scality am 8. Oktober beim Scality Day in Paris.
Der Wettbewerb im Überblick
Scality ist nicht allein. Der Markt für KV-Cache-Auslagerung und disaggregiertes Serving ist umkämpft, und die meisten Speicheranbieter docken an das Inferenz-Framework NVIDIA Dynamo an. Dynamo trennt Prefill und Decode, verfügt über einen KV-aware Router und einen verteilten KV-Cache-Manager und überträgt Daten über die Bibliothek NIXL. Laut NVIDIA kann Dynamo den KV-Cache in CPU-RAM, lokale SSDs oder Netzwerkspeicher auslagern. Nach Informationen von Blocks & Files unterstützen unter anderem Cloudian, DDN, Dell, Hitachi Vantara, HPE, IBM, NetApp, Pure Storage, VAST Data und WEKA diese Technik.
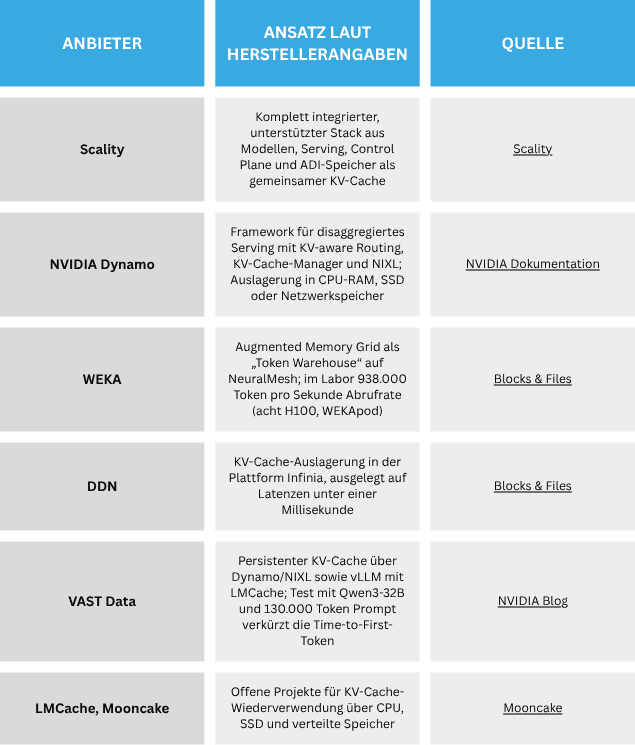
Der Unterschied liegt weniger in der Grundidee als im Lieferumfang. Die meisten Wettbewerber positionieren sich als Datenplattform oder Cache-Schicht innerhalb eines Stacks, den Kunden um Dynamo, vLLM oder LMCache selbst zusammensetzen. Scality verkauft dagegen den validierten Gesamtstack inklusive Wartung. Wer die Integrationsarbeit lieber selbst steuert, hat bei den Alternativen mehr Spielraum. Wer sie auslagern will, findet bei Scality ein Paket.
Was sagen Gartner, Forrester und IDC?
Die Analysten bewerten den Trend zur lokalen Inferenz insgesamt positiv, mahnen aber zur Differenzierung.
Gartner: In der Studie „How to Determine Infrastructure Requirements for On-Premises Generative AI“ (5. März 2025, ID G00825318) erwartet Gartner, dass bis 2028 mehr als 20 Prozent der Unternehmen KI-Workloads für Training oder Inferenz lokal betreiben, nach rund 2 Prozent Anfang 2025. Das Zitat ist über einen Beitrag von DDN überliefert, die Studie selbst ist kostenpflichtig. Ein Gartner-Abstract zu On-Premises-KI-Infrastruktur weist darauf hin, dass dort oft geringe GPU-Auslastung und schwache Kosteneffizienz bei der LLM-Inferenz auftreten. Im Juni 2026 widmete Gartner zudem ein Briefing dem Thema „The Case for On-Premises AI Inference“.
Forrester: In den Predictions 2026 sagt Forrester voraus, dass Private AI Factories 20 Prozent Verbreitung erreichen und On-Premises-Server 50 Prozent Marktanteil erobern. Wie beides abgegrenzt ist, steht im kostenpflichtigen Bericht. Laut IT Brief erwartet Forrester außerdem, dass mindestens 15 Prozent der Unternehmen private KI-Optionen suchen, statt Unternehmensdaten in öffentliche Cloud-Modelle zu geben.
IDC: Nataliya Yezhkova, Vice President Storage and Data Management, verweist in der Scality-Mitteilung darauf, dass IDC-Untersuchungen die lokale Inferenz für eine wachsende Zahl von Unternehmens- und Behörden-Workloads als praktikabel einstufen. Voraussetzung sei eine Infrastruktur, die Modellzustand effizient und skalierbar speichern und bereitstellen kann. Die Aussage stammt aus einer Herstellermitteilung, die zugrunde liegende IDC-Studie nennt sie nicht.
Futurum Group: Der Bericht AI Inference: Enterprise Infrastructure and Strategic Imperatives vom Januar 2026 sieht kein Cloud-first als Standard mehr. Die lokale Inferenz biete die niedrigsten Kosten pro Inferenz bei stabilen, hochvolumigen Workloads.
Kritische Einordnung: Worauf Unternehmen achten sollten
Die Mitteilung liefert viele Argumente, lässt aber Fragen offen. Die Messwerte stammen ausschließlich von Scality, und der zugehörige Blogbeitrag mit den Testdetails war beim Verfassen dieses Artikels nicht abrufbar. Preise und Lizenzbedingungen nennt die Mitteilung nicht, und sie erklärt nicht, unter welcher Lizenz der „Open Code“ steht. Der Begriff ist nicht mit Open Source im Sinne der Open Source Initiative gleichzusetzen. Zudem setzt der Ansatz GPU-Server und ein schnelles RDMA-Netz voraus, was Investitionen und Betriebswissen verlangt. Das Gartner-Abstract zu schwacher GPU-Auslastung zeigt, dass lokale Inferenz nur dann wirtschaftlich ist, wenn die Hardware ausgelastet bleibt.
Hinzu kommt der Blick auf die Befragungen: Auch die Umfrage von Cloudian unter 203 IT-Entscheidern, nach der 93 Prozent KI-Workloads bereits zurückgeholt haben oder dies prüfen, wurde von einem Speicheranbieter beauftragt. Die Daten zeigen eine deutliche Verlagerung der Inferenz, aber keinen vollständigen Rückzug aus der Cloud. Realistisch sind hybride Modelle, in denen kritische, stabile Workloads lokal laufen und Lastspitzen in der Cloud.
Fazit
Die Inference Factory beschreibt weniger ein neues Produkt als eine Architekturidee: Modelle lokal betreiben, Prefill und Decode trennen und den KV-Cache auf einen schnellen, gemeinsamen Speicher auslagern. Die Forschung stützt das Prinzip, und die Analysten sehen wachsende Bedeutung für On-Premises-Inferenz. Scalitys Alleinstellungsmerkmal ist der gelieferte und gewartete Gesamtstack. Ob sich der Ansatz rechnet, entscheidet die eigene Auslastung. Unternehmen sollten die Herstellerwerte daher im Proof of Concept mit eigenen Modellen und Lastprofilen prüfen.
Q&A: Häufige Fragen zur Inference Factory
Was ist eine Inference Factory?
Eine Inference Factory ist ein integrierter Stack aus Modellen, Serving-Schicht, Control Plane und Speicher, der KI-Modelle im eigenen Rechenzentrum produktiv ausführt. Der Begriff ist kein Standard, sondern leitet sich von der AI Factory ab.
Was ist der Unterschied zwischen Training und Inferenz?
Beim Training lernt ein Modell aus Daten. Bei der Inferenz wendet es das Gelernte auf neue Eingaben an. Laut Gartner übersteigen die Ausgaben für Inferenz 2026 erstmals die für Training.
Was ist ein KV-Cache und warum ist er wichtig?
Der KV-Cache speichert den bereits verarbeiteten Kontext einer Anfrage. Wird er ausgelagert und wiederverwendet, muss die GPU den Kontext nicht neu berechnen. Das spart Rechenzeit, besonders bei langen Kontexten und Agenten.
Was bedeutet disaggregiertes Serving?
Prefill und Decode laufen auf getrennten GPU-Pools und skalieren unabhängig. Die Studie DistServe zeigt, dass dies bis zu 7,4-mal mehr Anfragen bei gleichen Latenzzielen ermöglichen kann.
Wer bietet vergleichbare Lösungen an?
Neben Scality arbeiten unter anderem NVIDIA mit Dynamo, WEKA, DDN, VAST Data sowie offene Projekte wie LMCache und Mooncake an KV-Cache-Auslagerung und disaggregiertem Serving.
Lohnt sich lokale Inferenz immer?
Nein. Laut Futurum Group rechnet sie sich vor allem bei stabilen, hochvolumigen Workloads. Gartner weist auf das Risiko niedriger GPU-Auslastung hin. Oft ist ein hybrides Modell sinnvoll.