In der modernen Unternehmenswelt fließen gewaltige Summen in den Aufbau hochmoderner Dateninfrastrukturen. Doch hinter den glänzenden Fassaden aus Cloud-Speichern und Analyse-Tools stellt sich oft die ernüchternde Frage: Wie hoch ist die Dateneffizienz 2026 wirklich?
Mehr Daten, weniger Wirkung?
Dateneffizienz 2026: Strategischer Werttreiber statt verborgener Kostenfalle

Ohne präzise Messgrößen bleibt die Antwort meist im Bereich der Spekulation. Experten wie die von Denodo weisen in diesem Zusammenhang darauf hin, dass Dateneffizienz kein abstrakter IT-Begriff ist, sondern das Fundament für den geschäftlichen Erfolg bildet.
Die Messbarkeit des Erfolgs: Zentrale KPIs für die Datenarchitektur
Um Licht in das Dunkel der Datenkosten zu bringen, müssen Unternehmen von vagen Schätzungen zu belastbaren Kennzahlen übergehen. Nur wer misst, wie Daten fließen und wo sie stagnieren, kann den Hebel an der richtigen Stelle ansetzen. Dabei geht es nicht nur um technische Parameter, sondern um Kennzahlen, die unmittelbar den Geschäftserfolg widerspiegeln. Die vier zentralen KPIs sind: Time to Insight, Engineering-Produktivität, Data Quality Score (DQS) sowie Pipeline Reliability & Verfügbarkeit.
Time to Insight: Geschwindigkeit als Wettbewerbsvorteil
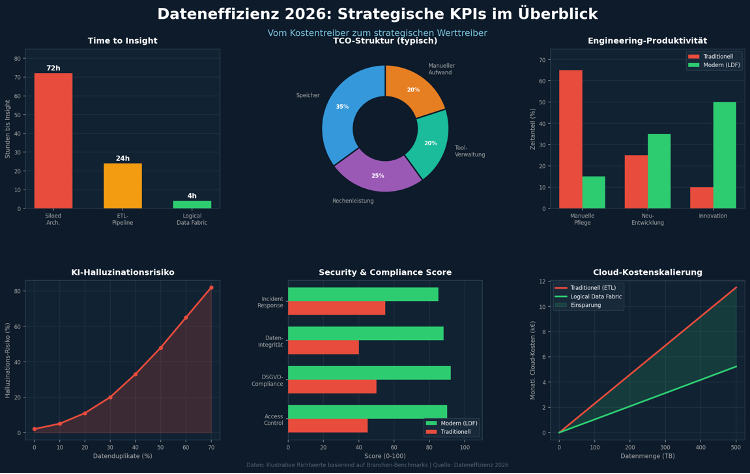
Ein zentraler Indikator für diesen Erfolg ist die sogenannte Time to Insight. Sie beschreibt die Zeitspanne, die verstreicht, bis aus strukturierten und unstrukturierten Rohdaten eine solide Entscheidungsgrundlage für den operativen Betrieb oder strategische KI-Anwendungen wird. Wenn Daten in isolierten Silos liegen und Architekturen fragmentiert sind, führt dies zwangsläufig zu Verzögerungen.
Unternehmen müssen dann Daten massiv replizieren oder komplexe Integrationsschichten manuell pflegen, was Innovationen bremst und den Vorsprung gegenüber agileren Wettbewerbern schrumpfen lässt. Die Messung ist dabei denkbar simpel: Es zählt allein die Zeit, die vergeht, bis ein Endnutzer ein fertiges Analysemodell oder Dashboard nutzen kann.
Engineering-Produktivität und Kostentransparenz (TCO)
Parallel dazu offenbart sich die Dateneffizienz einer Infrastruktur in der Produktivität des Data Engineering. Ein hoher manueller Aufwand für die Justierung von Prozessen deutet meist auf doppelte Pipelines und eine geringe Wiederverwertungsquote hin. Anstatt neuen Wert zu schöpfen, verbringen Experten ihre Zeit mit der Wartung starrer Systeme. Um die Kosteneffektivität wirklich zu durchdringen, reicht ein Blick auf die reinen Anschaffungskosten nicht aus.
Erst die Berechnung der Total Cost of Ownership (TCO), die Rechenleistung, Speicher, Toolverwaltung und Personalkosten einbezieht, macht die Skalierbarkeit transparent. In einer Welt, die sich durch regulatorische Vorgaben und dynamische Märkte ständig wandelt, wird zudem die Agilität zur Überlebensfrage.
Data Quality Score (DQS): Messbarkeit der Datenqualität
Ein oft vernachlässigter, aber kritischer KPI ist der Data Quality Score (DQS). Er erfasst den Anteil der Datensätze, die definierte Qualitätskriterien erfüllen – darunter Vollständigkeit, Aktualität, Konsistenz und Eindeutigkeit. Branchen-Benchmarks zeigen, dass Unternehmen mit einem DQS unter 80 % bis zu 30 % ihrer Data-Engineering-Kapazität für die nachträgliche Datenbereinigung aufwenden müssen. Ein kontinuierliches DQS-Monitoring ist daher eine Voraussetzung, um KI-Modelle mit verlässlichen Trainingsdaten zu versorgen und fehlerhafte Entscheidungen zu vermeiden.
Pipeline Reliability & Verfügbarkeit: Das operative Rückgrat
Eng damit verknüpft ist die Pipeline Reliability, also die Zuverlässigkeit und Verfügbarkeit von Datenpipelines. Ausfälle oder verzögerte Datenlieferungen führen direkt zu gestörten Geschäftsprozessen und erhöhen den manuellen Korrekturaufwand erheblich. Ein SLA-konformer Betrieb mit klaren Schwellenwerten für Latenzen und Fehlerquoten ist deshalb integraler Bestandteil einer reifen Datenstrategie. Moderne Observability-Tools wie Monte Carlo Data oder Great Expectations ermöglichen proaktives Monitoring und verkürzen die mittlere Wiederherstellungszeit (MTTR) signifikant.
Strategische Rentabilität: Der ROI der Dateneffizienz
Um die theoretischen Vorteile in eine betriebswirtschaftliche Realität zu übersetzen, verdeutlicht ein Blick auf die Total Cost of Ownership (TCO) das enorme Einsparpotenzial. Ein typisches Unternehmen, das bisher auf starre, manuelle ETL-Pipelines und physische Datenreplikation setzte, sieht sich oft mit einer Kostenstruktur konfrontiert, bei der allein 35 % des Budgets in Speicher und 20 % in manuellen Wartungsaufwand fließen. Durch den Umstieg auf eine Logical Data Fabric lassen sich diese „stillen Kosten“ massiv reduzieren.
In einem realistischen Szenario für das Jahr 2026 führt die Implementierung einer logischen Schicht zu einer Reduktion des Engineering-Aufwands um etwa 40 %, da Experten weniger Zeit mit der Reparatur fragmentierter Pipelines und mehr mit wertschöpfenden Innovationen verbringen können. Hinzu kommt eine signifikante Senkung der Cloud-Gebühren: Durch intelligente Deduplikation und den Verzicht auf unnötige Datenbewegungen lassen sich die Infrastrukturkosten für Speicher und Rechenleistung um bis zu 30 % optimieren.
Besonders eindrucksvoll zeigt sich der Return on Investment bei der Time to Insight. Während traditionelle Silo-Architekturen oft Tage benötigen, um Daten entscheidungsreif aufzubereiten, verkürzt die logische Abstraktion diesen Prozess auf wenige Stunden. Wenn man diese gewonnene Agilität und die vermiedenen Kosten für KI-Fehlentscheidungen durch schlechte Datenqualität (DQS) gegen die Lizenz- und Einführungskosten aufrechnet, erreichen viele Unternehmen bereits im ersten Jahr einen positiven ROI, der sich in den Folgejahren durch wegfallende Implementierungskosten weiter steigert. Die Berechnungen basieren auf Branchen-Benchmarks von Analysten wie Gartner und BARC sowie dem „Total Economic Impact (TEI) “-Framework von Forrester Research. Nach deren Forschung zu Data Virtualization, so die Denodo-Experten, zeigt sich eine 83% Reduktion der Time-to-Revenue und 65% geringere Delivery-Zeiten gegenüber ETL.
Sicherheit und Sauberkeit: Die unsichtbaren Säulen der Effizienz
Die rein betriebswirtschaftliche Betrachtung greift jedoch zu kurz, wenn man die modernen Herausforderungen der IT-Sicherheit und Daten-Deduplikation ignoriert. Effizienz bedeutet heute auch, die Integrität und den Schutz der Informationen sicherzustellen, da jeder Sicherheitsvorfall die mühsam gewonnenen Effizienzvorteile sofort zunichtemacht.
Security by Design: Risikominimierung durch zentrale Governance
Ein effizientes System minimiert die Angriffsfläche. Durch die Reduzierung unnötiger Datenkopien sinkt nicht nur der Speicherbedarf, sondern auch das Risiko für Sicherheitslecks an vergessenen Speicherorten. Eine logische Datenschicht ermöglicht es hierbei, Sicherheitsrichtlinien zentral zu steuern. Anstatt Berechtigungen mühsam in jedem einzelnen Quellsystem zu implementieren, wird eine einheitliche Governance über alle Datenströme hinweg gelegt. Dies schützt sensible Informationen und vereinfacht die Einhaltung strenger Compliance-Vorgaben wie der DSGVO massiv.
Daten-Deduplikation: Effiziente Ressourcennutzung ohne Daten-Müll
Gleichzeitig bekämpft die Deduplikation den wachsenden „Daten-Müll“. In vielen Unternehmen existieren identische Datensätze in zigfacher Ausführung auf unterschiedlichen Servern. Durch intelligente Deduplikations-Verfahren werden diese Dubletten identifiziert und durch eindeutige Referenzen (Pointer) ersetzt, sodass die Daten nur einmal physisch gespeichert werden. Dies senkt nicht nur die Cloud-Speicherkosten drastisch, sondern schont auch die Rechenpower bei Suchanfragen. Ein schlankes Datensystem ist schneller, kostengünstiger und leichter zu verwalten.
Die KI-Falle: Warum Dateneffizienz über den Erfolg von Machine Learning entscheidet
Besonders kritisch wird das Thema Dateneffizienz im Kontext von Künstlicher Intelligenz. Viele Unternehmen stürzen sich auf Generative AI, vergessen dabei aber die Qualität ihrer Datenbasis. Werden KI-Modelle mit inkonsistenten Informationen aus verschiedenen Quellen gefüttert, führt dies zwangsläufig zu fehlerhaften Ergebnissen oder sogenannten „Halluzinationen“.
Dateneffizienz fungiert hier als Qualitätsfilter: Sie stellt sicher, dass KI-Agenten nur auf die „Single Source of Truth“ zugreifen – ein Prinzip, das insbesondere bei RAG-Architekturen (Retrieval-Augmented Generation) entscheidend ist, da hier die Qualität der abgerufenen Dokumente direkt die Antwortgüte des Modells bestimmt. Zudem droht ohne effiziente Datenabfragen eine Kostenexplosion: Ineffiziente Abfrage-Algorithmen von KI-Systemen können die Cloud-Gebühren innerhalb kürzester Zeit unkontrolliert in die Höhe treiben.
Expertentipp: Die „Integritäts-Garantie“ für Ihre KI-Strategie 2026
Analysten wie BARC und Gartner betonen für das Jahr 2026 einen entscheidenden Paradigmenwechsel: Der Fokus verschiebt sich weg von der reinen KI-Modellierung hin zur Datenintegrität. Das Risiko von „KI-Halluzinationen“ und explodierenden Cloud-Kosten ist heute realer denn je, wenn die Datenbasis fragmentiert ist. (Quelle: BARC Trend Monitor 2026 „Datenqualität schlägt KI-Hype“; Gartner Magic Quadrant & Hype Cycle for Data Management)
Die Empfehlung der Experten: Setzen Sie auf eine Logical Data Fabric. Anstatt Daten physisch in riesige Data Lakes zu kopieren (was Dubletten und Sicherheitslücken schafft), fungiert die logische Schicht als intelligenter Filter. „Dateneffizienz im Jahr 2026 bedeutet nicht mehr nur Speicherplatz zu sparen. Es bedeutet, eine Single Source of Truth in Echtzeit bereitzustellen, damit KI-Agenten auf verifizierte, deduplizierte und sichere Informationen zugreifen können. Wer heute noch auf massenhafte Replikation setzt, baut die technischen Schulden von morgen.“
(Insight aus aktuellen Management-Reports 2026)
Strategische Lösung: Das logische Datenmanagement als Befreiungsschlag
Der Weg aus dem Dilemma zwischen Datenwachstum und Kostenkontrolle führt über das logische Datenmanagement. Indem der Datenzugriff von den physischen Systemen entkoppelt wird, entsteht eine virtuelle Schicht, die physische Replikationen weitgehend überflüssig macht. Dies steigert die Produktivität der Ingenieure durch weniger manuellen Aufwand, verbessert die Agilität bei neuen Projekten und führt durch die Reduktion unnötiger Datenbewegungen zu einer spürbaren Verbesserung der Kosteneffektivität.
Skalierbare Dateneffizienz: Von KMU bis Enterprise
Die Prioritäten einer Dateneffizienz-Strategie verschieben sich je nach Unternehmensgröße deutlich. Während für kleine und mittlere Unternehmen (KMU) oft die unmittelbare Senkung von Cloud-Fixkosten und die Konsolidierung weniger Kernsysteme im Vordergrund stehen, fokussiert sich der gehobene Mittelstand primär auf die Steigerung der Engineering-Produktivität, um dem Fachkräftemangel entgegenzuwirken. Im Enterprise-Umfeld hingegen wird die logische Datenschicht zum unverzichtbaren Anker für Governance und Compliance. Hier geht es darum, tausende fragmentierte Datenquellen sicher zu steuern und eine „Single Source of Truth“ für globale KI-Initiativen bereitzustellen, ohne die Souveränität über sensible Informationen zu verlieren.
Vergleich: Traditionelle vs. Moderne Datenarchitektur
| Merkmal | Traditionell (ETL/Silos) | Modern (Logisches Datenmanagement) |
| Datenkopien | Hoch (redundant & teuer) | Minimal (virtueller Zugriff) |
| Sicherheit | Dezentral & lückenhaft | Zentralisiert & konsistent |
| Deduplikation | Manuell / schwierig | Automatisiert / nativ integriert |
| KI-Bereitschaft | Gering (Gefahr von Halluzinationen) | Hoch (Single Source of Truth) |
| Kostenstruktur | Linear steigend mit Datenmenge | Skalierbar & verbrauchsoptimiert |
Q&A
Wie lässt sich Dateneffizienz konkret im Unternehmen verankern und messen?
Dateneffizienz entsteht nicht zufällig, sondern durch klare Verantwortlichkeiten und messbare Zielwerte. Unternehmen sollten Dateneffizienz als strategischen KPI definieren, der regelmäßig anhand von Time to Insight, Data Quality Score, Pipeline Reliability und Total Cost of Ownership bewertet wird. Entscheidend ist, dass Fachbereiche und IT gemeinsam Zielwerte festlegen, etwa maximale Datenlatenz oder definierte Qualitätsgrenzen. Erst wenn Dateneffizienz Teil der Governance und der Management-Reports ist, wird sie vom IT-Thema zum echten Werttreiber für das gesamte Unternehmen.
Warum ist Deduplikation für die KI so wichtig?
KI-Modelle gewichten Informationen basierend auf deren Häufigkeit. Sind Daten redundant vorhanden, wird das Modell verzerrt (Bias), was die Vorhersagequalität mindert und zu Fehlentscheidungen führt.
Wie verbessert eine logische Schicht die IT-Sicherheit?
Sie fungiert als zentraler Kontrollpunkt. Sicherheitsrichtlinien werden einmalig auf der logischen Ebene definiert („Global Policy Enforcement“) und gelten sofort für alle angeschlossenen Datenquellen.
Was ist der größte Hebel zur Kostensenkung?
Die Reduzierung der Datenbewegung. Jedes Mal, wenn Daten kopiert oder verschoben werden, fallen Kosten für Rechenleistung und Speicher an. Logisches Management minimiert diese Bewegungen auf ein Minimum.
Weiterführende Infos:
1. Webinare & Podcasts (Aktuell & On-Demand)
- Denodo Podcast: „2026 Data Predictions“ Dieses aktuelle Format beleuchtet den Übergang vom „KI-Hype“ zur „Governed Reality“. Es erklärt, warum das Fundament für Agentic AI (autonome KI-Agenten) zwingend ein logisches Datenmanagement erfordert.
- Fokus: KI-Readiness und Data Fabric.
- Link: Denodo Podcast Series
- Live-Webinar: „Rethinking Your Data Strategy in the Age of AI“ (Februar 2026) Ein brandneues Webinar, das sich mit organisatorischen Veränderungen befasst, die für Self-Service und KI-Genauigkeit notwendig sind.
- Link: Denodo Webinars
2. Whitepaper & Trend-Reports 2026
- Alation: „2026 Data Management Trends“ Dieses Whitepaper ist Pflichtlektüre für CDOs und Datenarchitekten. Es behandelt den Wandel hin zu „Composable Architectures“ und wie KI als Kraftmultiplikator für Governance und Datenqualität fungiert.
- Key Takeaway: Warum Metadaten 2026 die wichtigste Ressource für vertrauenswürdige KI sind.
- Link: Alation Blog/Whitepaper
- BARC Trend Monitor 2026: „Datenqualität schlägt KI-Hype“ Das renommierte Analystenhaus BARC zeigt auf, dass Datenqualität nach Jahren wieder auf Platz 1 der wichtigsten Themen steht – eben um die „KI-Falle“ zu vermeiden.
- Link: BARC.com
3. IT-Sicherheit & Compliance
- G DATA Webinar-Reihe: „IT Security im Fokus 2026“ Hier findest du spezifische Sessions zu NIS-2 (der neuen EU-Richtlinie für Cyber-Resilienz) und wie KI Phishing-Angriffe revolutioniert. Das ist die perfekte Ergänzung zum Thema „Security by Design“.
- Link: G DATA Business Webinare
4. Video-Insights (Kurz & Prägnant)
- YouTube: „Digitalisierung im Wandel – Perspektiven für 2026“ Ein guter Überblick über die Vernetzung von Digitalprojekten in nachhaltige Strategien.
- Link: YouTube