Microsoft hat die dritte Generation seines Inferenz-Beschleunigers vorgestellt. Ab 2027 soll Maia im Multi-Gigawatt-Maßstab eingesetzt werden.
96 Beschleuniger pro Rack
Maia 300: Microsofts KI-Chip mit 288 GB HBM4
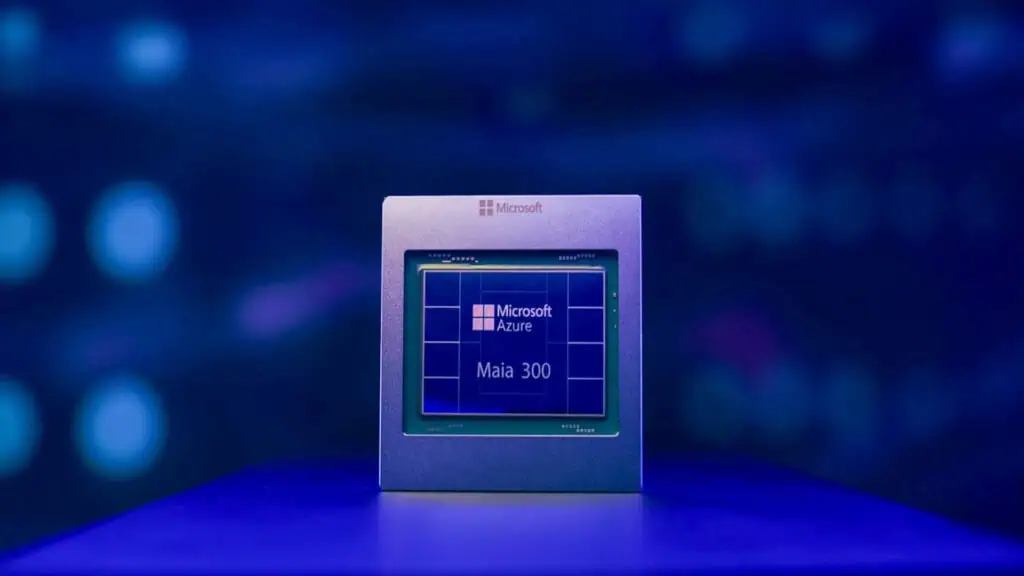
Bildquelle: Microsoft
Microsoft hat mit Maia 300 die dritte Generation seines selbst entwickelten KI-Beschleunigers vorgestellt. Der Chip ist auf Inferenz ausgelegt, also auf das Ausführen trainierter Sprachmodelle, und soll künftig eine zentrale Rolle beim Betrieb der KI-Dienste des Unternehmens spielen. Ab 2027 will Microsoft Azure Maia auf Installationen im Multi-Gigawatt-Maßstab ausweiten. Den Vorgänger Maia 200 hatte das Unternehmen im Januar 2026 vorgestellt.
Rechenkerne in 2 Nanometer
Maia 300 besteht aus mehreren Chiplets. Die Recheneinheiten werden bei TSMC im Prozess N2P gefertigt, Speichercontroller und Ein-/Ausgabefunktionen sitzen auf separaten Dies. Jeder Beschleuniger verfügt über acht HBM4-Stapel mit zusammen 288 GB und einer Bandbreite von 18 TB/s. Gegenüber Maia 200 entspricht das nach Microsoft-Angaben der 2,5-fachen Speicherbandbreite und 33 Prozent mehr Kapazität. Die Rechenleistung in FLOPs steigt um 36 Prozent. Neue Datenformate mit geringer Genauigkeit, darunter ein erweitertes MXFP4 und Speicherformate unter 3 Bit, sollen die pro Token bewegte Datenmenge verringern.
96 Beschleuniger pro Rack
Ein Rack fasst 96 Beschleuniger in 24 Einschüben mit je vier Chips bei einer Leistungsaufnahme von 167 Kilowatt, doppelt so viele wie bei Maia 200. Über ein zweistufiges Netzwerk auf Ethernet-Basis lassen sich bis zu 128 Racks mit zusammen 12.288 Beschleunigern zu einem sogenannten Superpod verbinden. Innerhalb des Racks laufen die Verbindungen elektrisch, zwischen den Racks optisch. Flüssigkeitskühlung führt mehr als 80 Prozent der Wärme ab. Das System kann direkt an die Wasserversorgung eines Rechenzentrums angeschlossen oder über Wärmetauscher in luftgekühlten Rechenzentren betrieben werden.
Nach Angaben von Microsoft verarbeitet Maia 300 durch Effizienzsteigerungen im Gesamtsystem 40 Prozent mehr Tokens pro Megawatt. In der vollen Konfiguration mit 96 Beschleunigern soll der Token-Durchsatz pro Rack bis zu siebenmal so hoch sein wie bei Maia 200, die Leistung pro Watt mehr als 2,5-mal so hoch. Unabhängige Messungen liegen nicht vor.
Für agentische Workloads
Ausgelegt ist das System laut Microsoft auf Reasoning über lange Kontexte, Dialoganwendungen mit kurzen Antwortzeiten sowie dauerhafte, mehrstufige agentische Aufgaben. Maia 200 und Maia 300 sollen unter anderem GitHub, Microsoft Foundry und Dragon Copilot unterstützen. Weitere Details will Microsoft auf der Konferenz Ignite vom 17. bis 20. November in San Francisco vorstellen.
(red/Microsoft)