Neben Themen wie „Self-Sovereign Identity“ (SSI) und der neuen EU-Verordnung eIDAS 2.0 rund um Wallets, Vertrauensdienste und Interoperabilität beschäftigt die Identity Management Experten kaum ein Konzept mehr, als fein-granulare Autorisierung (FGA).
Identity & Access Management
Fein-granulare Autorisierung – warum der Hype?
Das von Google im Jahre 2019 auf der USENIX Konferenz vorgestellte „Zanzibar“ Konzept für ein globales Autorisierungssystem wurde nur von wenigen Spezialisten wahrgenommen, aber dafür umso intensiver betrachtet. Das Vorhaben, neben der Identifikation und Authentisierung von Anwendern (etwa über die Nutzung von Kerberos in den Grenzen der eigenen Active Directory Domäne, oder per SAML 2.0 im Internet) auch die Autorisierung zu zentralisieren, ist keinesfalls neu: bereits in den frühen 2000er Jahren entstand bei der OASIS der XACML Standard, der zuletzt in 2013 mit Version 3.0 aktualisiert wurde. Das Konzept der Entkoppelung fein-granularer Autorisierungsentscheidungen und der Zentralisierung der Verwaltung der Regeln und Policies hierfür ist also bekannt – konnte sich jedoch nie richtig etablieren.
Altlasten und Beweggründe
Zwar waren die Gründe für den ausbleibenden, durchschlagenden Erfolg vielfältig – aber auch heute gilt XACML nicht als „vollkommen gescheitert“. Lediglich die eher komplexe Umsetzung des Standards in reale Produkte und Lösungen und die fehlende Agilität der Software-Entwicklung haben die Adaption erschwert und viele Unternehmen scheuten den Aufwand des notwendigen Refactoring, um ihre Bestands-Software auf das neue Paradigma umzustellen. Ein Grund, warum auch im Jahre 2023 noch Anwendungen mit komplett interner Benutzerverwaltung existieren und Microsoft erheblichen Aufwand betreibt, Altlasten wie das unsichere NTLM endlich aus dem Verkehr zu ziehen und Unternehmen auf die Vorteile moderner Authentisierungs- und Autorisierungsverfahren hinzuweisen. Auch die anstehende oder bereits in Umsetzung befindliche Migration etablierter on-premise Anwendungen in die Cloud bringt Unternehmen von sich aus in Zugzwang, alte Zöpfe abzuschneiden und den Mehrwert in die Jahre gekommener Software zu bewerten. Hierbei ist die Betrachtung der Benutzer- und Rechteverwaltung ein wichtiger Aspekt für die Beurteilung der Migrationsfähigkeit von Altbestand, bzw. zur Bewertung des Aufwandes für ein Refactoring.
Bisherige Entwicklung
Bereits in den frühen 2000er Jahren hatten die erhebliche Verbreitung von Web-Anwendungen sowie der sanfte Niedergang der (teilweise mit Kerberos integrierten) Three-Tier Applikationsarchitektur mit Fat Client GUIs zu einem Wildwuchs an Benutzerkonten und dedizierten Passworten in Web-Apps geführt, dem die Unternehmen mit Web-SSO Systemen entgegenwirken wollten. Die Nutzung von Skript-basierten Methoden zum Scraping der Credentials und deren automatisierten Einfügen in die Webmasken waren jedoch – neben der teilweise unverschlüsselten Übertragung per http – unschöne Begleiterscheinungen, so dass die (aus dem AD mit Kerberos bekannte) Nutzung von Token statt der Eingabe von Credentials bevorzugt wurde. Leider standen viele der Web-Applikationen aber gar nicht im eigenen RZ bzw. in „line of sight“ zum eigenen AD-Controller, so dass besagtes Kerberos keine direkte Option war. Neben dem von Microsoft geförderten WS-* Standard konnte sich in den folgenden Jahren das breit unterstützte SAML (Security Assertion Markup Language) Protokoll für Föderation etablieren, dessen Erfolg durch die Adaption der Version 2.0 in Microsofts eigenem Active Directory Federation Server 2.0 bekräftigt wurde. Seither erfreut sich SAML 2.0 für jegliche Form von Web-Anwendungen stabiler Unterstützung – der Erfolg der mobilen Geräte und der damit einhergehenden Verbreitung von Mobile Apps setzten dem Siegeszug jedoch Grenzen, da sowohl die verwendeten Cookies als auch die recht hohen Ressourcenanforderungen des Protokolls und seiner Sicherheitsmechanismen die Nutzung auf Mobilgeräten erschwerten.
Ja/Nein Entscheidung
Dazu kam, dass man zwar mit SAML eine lokale Anmeldung an der Applikation durch eine Anmeldung am eigenen Identity Provider (IdP) ersetzen kann und somit nur Token ausgetauscht werden, statt dem potenziell unsicheren Übertragen von Nutzername und Passwort über das Internet – eine über das einfache „Ja/Nein“ zum Zugriff hinaus gehende Verwaltung feiner abgestufter Berechtigungen ist jedoch im SAML-Protokoll nicht vorgesehen. Damit eignen sich SAML-basierte Föderationen zwar als Gatekeeper, komplexere Abfragen zum „wer darf hier warum was wo und wie machen“ sind jedoch nicht ohne Umstände abbildbar.
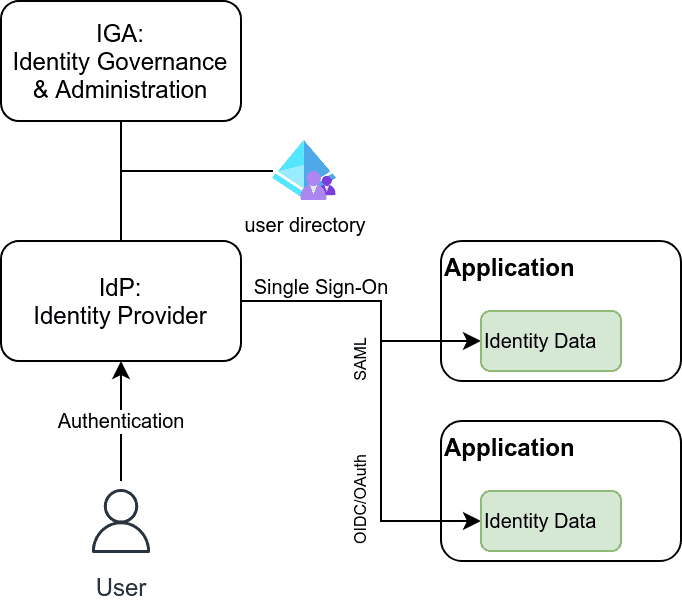
Bild 1: Auslagerung von Benutzerinformationen in einen IdP
Die Problemstellung der Mobil-Apps wurde zeitnah durch die Etablierung neuer Protokolle wie OAuth 2.0 und Open ID Connect (OIDC) angegangen, die auch die Herausforderung der immer wiederkehrenden Registrierung an neuen Services deutlich entschärfen konnten (wer kennt ihn nicht, den berühmten „oder registrieren Sie mich mit Google/Facebook/LinkedIn“ Knopf auf den Websites neuerer Dienste). Ein weiterer Vorteil der neueren Protokolle ist deren flexiblere Nutzung über die verschiedenen Flows (oder „Grants“), die (fehlende) Eigenschaften der beteiligten Parteien berücksichtigen (etwa der „Implicit Flow“, der die Authentifizierung des Clients durch den Authorization Server entfallen lässt, da sogenannte „Public Clients“ keine Möglichkeit zur sicheren Speicherung von Client Zugangsdaten aufweisen).
Identifikation – Authentisierung – Autorisierung?
Die Zentralisierung der Identifikation des Benutzers und dessen Authentisierung an einem Identity Provider kann als gelöst betrachtet werden – denn sowohl OAuth als auch SAML bieten hierfür jeweils für verschiedene Szenarien passende Lösungen und eine Vielzahl an kommerziellen und kostengünstigen Open Source Lösungen sind verfügbar. Was die zentrale Autorisierung angeht, stehen seit kurzem eine Reihe von neuen Technologien und Beschreibungssprachen zur Verfügung, die wir im kommenden Abschnitt beleuchten wollen. Da sich in deren Kontext vielfältige neue Akronyme etabliert haben, sollten wir diese zunächst einführen und erklären.
Aus dem seit den 90er bekannten Rollenmodell (RBAC – Role Based Access Control) wurden über die Zeit auch „Attribute-„ und „Context Based“ Varianten entwickelt (ABAC und CBAC), wie sie sehr anschaulich im „Conditional Access“ in Microsofts Azure Cloud (und an vielen anderen Stellen) zum Einsatz kommen. Hierbei ist nicht nur die Rolle der zugreifenden Entität wichtig (etwa Anwender oder Admin in der Applikation oder Einkäufer bzw. Controller auf Ebene der Job-Bezeichnung, bzw. als Business Rolle), sondern auch deren Eigenschaften („ist Mitarbeiter“, „hat Freigabelevel SENIOR“, „ist Mitglied der Gruppe ADMINISTRATOREN“) bzw. der aktive Kontext („ist angemeldet am AD“, „benutzt ein Firmengerät“, „befindet sich im Firmen-Netzwerk“). Neuere Varianten wie ReBAC (Relationship Based…) und PBAC (Policy Based…) runden das Bild ab, spezifizieren im Grunde jedoch nur die Art, wie Zugriffsrechte modelliert bzw. vergeben werden (mehr dazu weiter unten).
Um diesen Kontext und die Eigenschaften jedoch dynamisch in Zugriffsentscheidungen einbeziehen zu können, benötigen wir eine angepasste Architektur der Applikationen als auch der Infrastruktur. Diese lassen sich am besten herleiten, wenn die Komponenten nach einer bekannten Nomenklatur benannt und deren Eigenschaften beschrieben werden. Landläufig haben sich hierfür die folgenden Begriffe etabliert:
- PEP – Policy Enforcement Point: Die Komponente, welche eine Zugriffsentscheidung schlussendlich umsetzt. In der Regel ist dies eine Anwendung.
- PDP – Policy Decision Point: Fällt anhand von Regeln und Kontext-Informationen Zugriffsentscheidungen für den Enforcement Point
- PAP – Policy Administration Point: Zentrale Management-Komponente zur Verwaltung von Policies, Monitoring und Protokollierung von Entscheidungen des PDPs
- PIP – Policy Information Point: Stellt bei Bedarf einem PDP zusätzliche (Meta-) Informationen über Benutzer und Ressourcen zur Verfügung
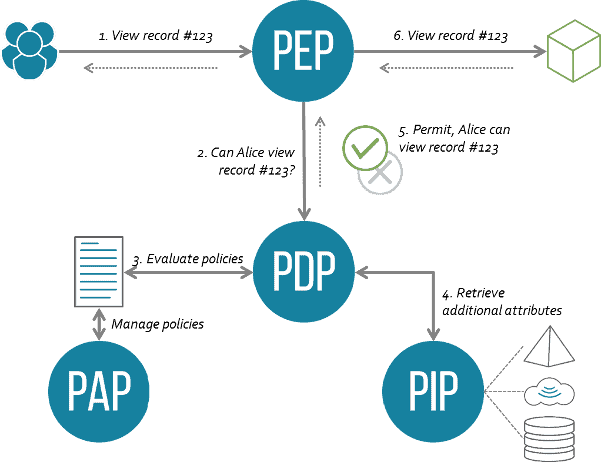
Bild 2: Policy Enforcement Komponenten (CREATIVE COMMONS Lizenz, Wikipedia)
In einer klassischen monolithischen Applikation sind alle Komponenten innerhalb der Applikation abgebildet, so dass sowohl ein lokales Benutzerkonto, lokales Passwort als auch lokal zugewiesene Berechtigungen in der Applikation verortet sind. Die Nachteile dieses Ansatzes liegen auf der Hand: Benutzerkonten (und Kennwörter) werden redundant in applikationseigenen „Silos“ verwaltet, die Steuerung und Durchsetzung von Berechtigungen erfolgt ebenfalls innerhalb des Silos der Applikation und nicht geschäftsprozessübergreifend.
Die erste Stufe zu einer modernen Anwendungsarchitektur stellt das „Outsourcing“ der Benutzerverwaltung (nebst Identifizierung und Authentisierung) und die Einführung von Single-Sign-On dar: Die hierzu erforderlichen Anpassungen am Anwendungs-Code und der Berechtigungslogik lassen sich in zwei Teilaspekte unterteilen:
1) Der gesamte Login-Prozess der Anwendung wird per SSO ausgelagert und an einen externen Identity-Provider übertragen, welcher alle notwendigen Informationen über den gerade aktiven Benutzer zur Laufzeit bereitstellt. Der Anpassungsaufwand hierfür ist in den meisten Fällen überschaubar und lässt sich häufig durch externe Module im Webserver oder einem vorgelagerten Reverse-Proxy verhältnismäßig einfach umsetzen.
In einem idealen Szenario muss sich die Anwendung anschließend nicht mehr um die Benutzerverwaltung kümmern – die Speicherung von Benutzern, nebst Kennwörtern und Nutzerdaten (Name, Vorname, und andere Eigenschaften) entfällt und wird zentral von einem externen Identity-Provider übernommen.
2) Das Berechtigungsmodell der Anwendung kann derart angepasst werden, dass wesentliche Zugriffsentscheidungen anhand benutzerbezogener Eigenschaften ausgemacht und getroffen werden können, wie beispielsweise „Ist Mitglied der Gruppe X“ oder „hat ADMINISTRATOR-Kennzeichen gesetzt“. Da diese Benutzerattribute per SSO durch den zentralen IdP gleich mitgeliefert werden, ergibt sich indirekt eine gewisse Auslagerung der Zugriffssteuerung: Die Anwendung verwaltet nicht mehr selbst, wer „Administrator“ oder „Mitglied der Gruppe X“ ist, sondern wendet ihre Zugriffsregeln entsprechend der jeweiligen Benutzereigenschaften zur Laufzeit an.
Die Vorteile des zweiten Aspekts werden schnell offensichtlich: Berechtigungsrelevante Benutzereigenschaften die für die Berechtigungssteuerung relevant sind (wie Gruppenmitgliedschaften oder Kennzeichen), können an zentraler Stelle und für alle Benutzer einheitlich verwaltet und per SSO über den Identity-Provider der jeweiligen Anwendung zur Laufzeit bereitgestellt werden.
Wie weiter oben bereits angedeutet ist eine wirklich feingranulare Zugriffssteuerung hier jedoch nicht möglich, weil sie durch die Fähigkeiten von SAML bzw. OpenID Connect (OIDC) begrenzt sind:
- Per SSO können schwerlich alle für die Zugriffssteuerung relevanten Benutzerdaten just-in-time an die Anwendung übermittelt werden. In realen Umgebungen ist es nicht unüblich, dass ein Benutzer in dutzenden Gruppen Mitglied ist. Der zulässige Speicherplatz für SAML/OIDC-Tokens wird jedoch durch das HTTP-Protokoll begrenzt und sollte in der Praxis eine Größe von 7 kB nicht übersteigen.
- SSO bildet nur eine Seite der Medaille ab: Identitätsdaten. Die Entscheidung darüber, welche Aktionen ein Benutzer konkret an welchen Objekten ausführen darf und warum, obliegt bei diesem Ansatz weiterhin vollständig der Anwendung. Mit Single Sign-On wird also nur ein Teilaspekt ausgelagert – nämlich die Authentisierung des Benutzers. Wird die Autorisierung weiterhin innerhalb der Anwendung umgesetzt, geschieht dies häufig mit Programmlogik wie sie exemplarisch und vereinfacht in Listing 1 abgebildet ist:
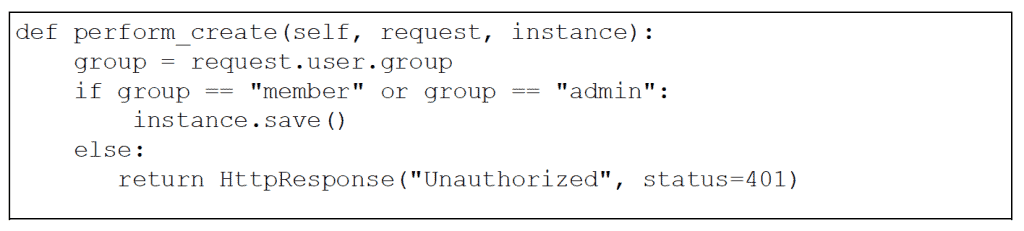
Listing 1
Obwohl Softwareentwickler in realen Projekten im Regelfall deutlich flexibleren (und komplexeren) Code verwenden um Zugriffsentscheidungen zu implementieren, verbleibt die eigentlich relevante Logik im Programmcode verborgen und ist schlussendlich weiterhin (mehr oder weniger) schwer zu warten und häufig intransparent.
Wenn man den aufgezeigten Trend zur Auslagerung und Zentralisierung fortführt, sollte nur noch die reine Business-Logik in der Applikation selbst erstellt werden, und eine dedizierte (und technologisch standardisierte) lokale Komponente für die Autorisierungs-Entscheidung diese Logik ergänzen um die Zugriffsentscheidungen auf Basis zentral definierter und verwalteter Policies zu treffen.
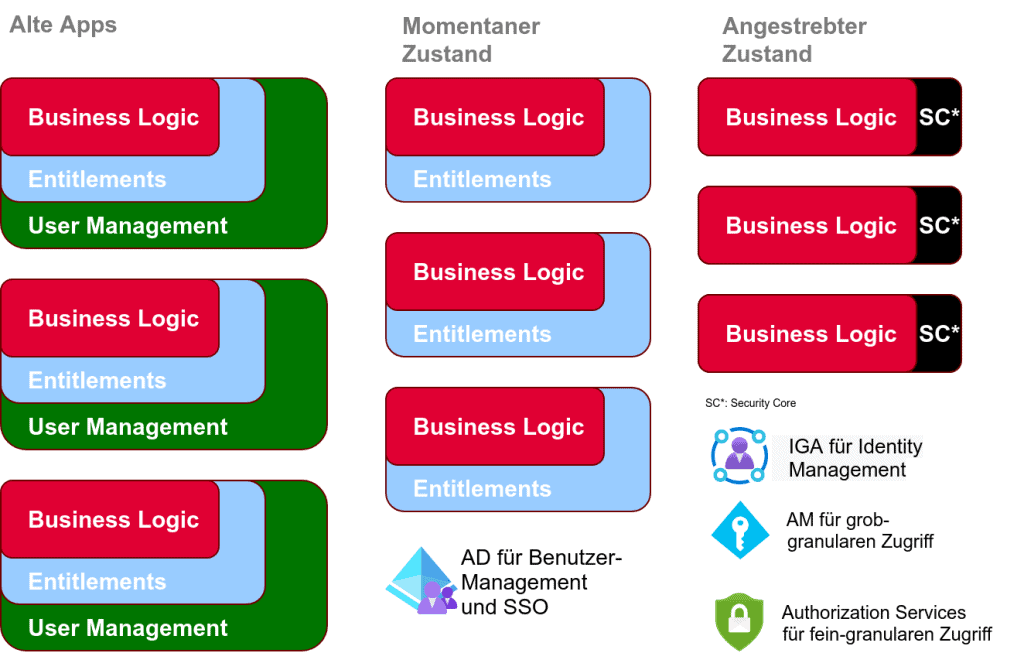
Bild 3: Evolutionsstufen der Auslagerung von Anwendungskomponenten
In einem Gesamtschaubild könnte eine mögliche Architektur dann wie folgt aussehen:
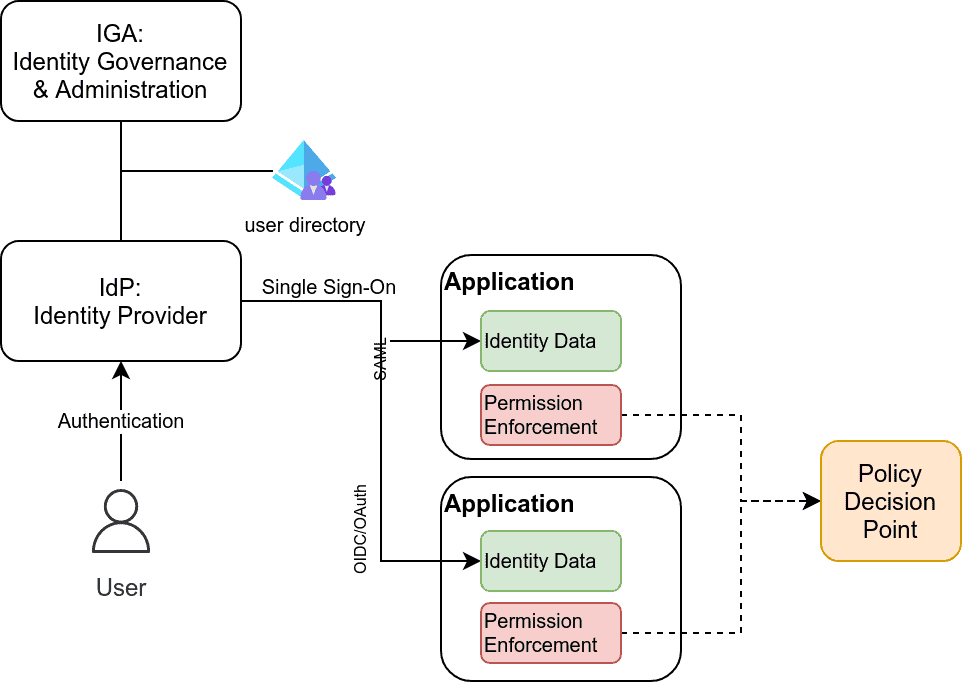
Bild 4: Komplett reduzierter Ansatz für die Auslagerung der Autorisierung
Eine Herausforderung – viele Lösungsansätze
Wer an dieser Stelle beginnt, nach Optionen zur Umsetzung zu suchen, kann an der Vielzahl relativ neuer Ansätze schnell die Übersicht verlieren. Als vermutlich bekanntester Vertreter der neuen Schule findet sich der OPA oder Open Policy Agent (kurz: OPA) – ein Open Source Projekt mit erstaunlicher Resonanz in der Entwickler Community. OPA bringt eigene Beschreibungssprache namens REGO mit, mit der sich einheitliche und verständliche Policies für Zugriffsentscheidungen formulieren lassen. Der OPA ist eine Implementierungsoption für den PDP und lässt sich verhältnismäßig einfach in neue Softwareprojekte einbinden.
Da Softwareentwicklung heute primär für die Cloud in der Cloud stattfindet und Anbieter wie AWS ein umfangreiches Tooling für CI/CD Pipelines und deren Automation anbieten, ist es wenig überraschend, dass mit CEDAR auch eine Beschreibungssprache von AWS um Aufmerksamkeit buhlt.
Eine Reihe von weiteren Anbietern wie Aserto, Sgnl und Co. nutzen intern den OPA als generische Komponente, um darauf aufbauend umfassendere Dienste und Funktionen anbieten zu können, während andere wie PlainID eigene Implementierungen bevorzugen.
Viele Lösungsansätze – eine abstrakte Lösung
Gemein haben alle diese Ansätze, dass sie abstrakt nur lösen wollen, wie man möglichst effizient, wiederverwendbar und sicher die für eine Autorisierung notwendigen Regeln und Bedingung in Form von Policies formulieren und diese performant zur Laufzeit der Anwendung Zugriffsentscheidungen auswerten kann. Im Unterschied zur Authentisierungsschicht – wo es lediglich um die Frage „Wer ist der Benutzer?“ geht – kommen bei Zugriffsentscheidungen in den meisten Fällen drei Aspekte zur gemeinsamen Betrachtung zusammen:
- ein Subjekt (wer): Der agierende Benutzer, welcher eine Aktion ausführen möchte
- eine Aktion, die der Benutzer ausführen möchte, z.B. „bearbeiten“ oder „löschen“
- eine Ressource, auf welcher eine Aktion ausgeführt werden soll, z.B. ein Dokument oder eine Datei
Die konkrete Ausgestaltung dieser „Triplets“ ist dabei sehr stark vom jeweiligen Anwendungsumfeld abhängig, vereinfachend kann man aber mit dem bekannten „CRUD“-Schema aus (CREATE – READ – UPDATE – DELETE) als Beispiel beginnen (für eine Datei als Ressource wären auch ACTIONS wie „RENAME“ oder „PRINT“ sinnvoll).
Die Bausteine SUBJECT, RESOURCE und ACTION werden dann in Policies verwendet, um zu formulieren, welche Anforderungen erfüllt sein müssen, damit ein Zugriff gewährt oder verweigert werden soll. Eine solche Policy könnte frei formuliert beispielsweise lauten:
„Eine RESSOURCE darf nur dann gelöscht werden, wenn das SUBJECT sich per MFA angemeldet hat und entweder (a) Mitglied in der Gruppe „admin“ ODER (b) Eigentümer dieser Ressource ist.“
Listing 2 zeigt, wie solch eine Policy am Beispiel von REGO mit dem Open Policy Agent umgesetzt werden könnte:
Standardmäßig ist jeder Zugriff zu verweigern, was über die Zeile 2 als entsprechender Default-Wert definiert wird. In den nachfolgenden Zeilen werden einzelne Aspekte in Form von Teil-Policies geprüft, nämlich ob das SUBJEKT in einer bekannten Gruppe ist (Zeile 4-8), ob das SUBJEKT Eigentümer der RESSOURCE ist (Zeile 9-11) oder ob die Authentifizierung per MFA erfolgte (Zeile 12-15). Das eigentliche Herzstück der Policy bilden die Bedingungen den darauffolgenden Blöcken in den Zeilen 16-27 ab, mit denen die eigentlichen Anforderungen in ihrer Kombination formuliert und ausgewertet werden. Nur wenn alle genannten Bedingungen zutreffen, wird die Policy für „allow“ den gewünschten Wert „true“ zurückliefern.
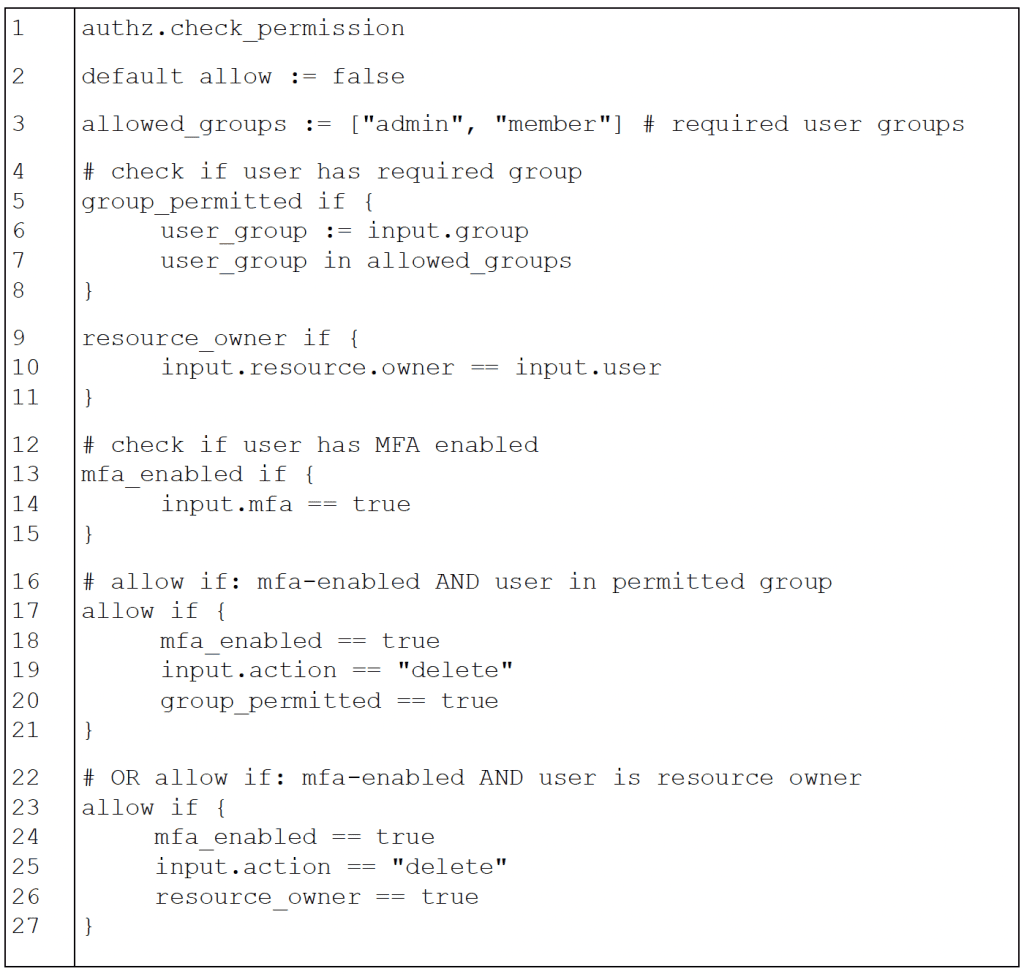
Listing 2
Fein-granulare Autorisierung
Mit einer solchen Policy ausgestattet, kann eine Anwendung nun jegliche Autorisierungsentscheidungen an einen externen Policy Decision Point (PDP) wie den Open Policy Agent auslagern und muss dazu lediglich den jeweiligen Kontext mitliefern: wer ist das SUBJEKT, was die RESSOURCE und welche AKTION ausgeführt werden soll. Im Gegenzug muss die Anwendung einzig nur noch die Entscheidung des PDP („allow“) auswerten und entsprechend umsetzen. Das vorliegende Beispiel ist bewusst einfach gehalten und verzichtet auf fortgeschrittene Techniken wie wiederverwendbare Sub-Policies, oder die Einbindung externer Datenbanken die als Policy Information Service (PIP) bei Bedarf nach zusätzlichen Informationen über Subjekte und Ressourcen befragt werden können. Nichtsdestotrotz demonstriert es, wie mächtig der Ansatz generell ist und welche Vorteile sich daraus ergeben:
- Zugriffsregeln werden in einer universellen Beschreibungssprache formuliert und in einem zentralen Policy-Register (Policy-Store) gesammelt.
- Alle Policies können über einen gemanagten Review- und Freigabeprozess kontrolliert erstellt und freigegeben werden.
- Die Entscheidungslogik wird von der Anwendung an einen PDP delegiert, welcher neben der eigentlichen Auswertung auch gleich die Protokollierung vereinheitlicht, und für einen besseren Überblick sorgt.
- Feingranulares Zugriffsmanagement kann konsistent über die gesamte Applikationslandschaft hinweg realisiert werden; unabhängig von der Programmierumgebung der jeweiligen Anwendung existiert eine universelle Beschreibungssprache mit der sich selbst komplexe Policies geschäftsprozess- und anwendungsübergreifend formulieren lassen.
Fazit
Das Thema feingranulare Autorisierung ist für alle Unternehmen mit eigenen Projekten in der Softwareentwicklung ein relevanter Agendapunkt für den Austausch zwischen CTO, CIO und der Anwendungsentwicklung. Gerade bei agilen Entwicklungsprojekten und einem dynamischen Umfeld in der IT sollte über eine weitergehende Zentralisierung des Access Management und eine Ergänzung um Authorization Services nachgedacht werden. Für lediglich „konsumierende“ IT-Abteilungen mit vornehmlich SaaS-basierten externen Services kann FGA zwar auch interessant sein, man ist dann jedoch auf eher Attribut- und Kontext-bezogene Policy-Erweiterungen für die „JA/NEIN“ Entscheidung limitiert, da ein Eingriff in die Applikationslogik oft nicht möglich ist.
Tags