Im abgelaufenen Jahr gab es technische Fortschritte bei der Modellgröße (175 Milliarden Parameter!) und es zeigten sich die Möglichkeiten, KI mit Aufmerksamkeit auszustatten – die Fähigkeit zu lernen, auf welchen Teil der Daten sie sich konzentrieren soll.
Aufmerksamkeitsbasierte KI hat inzwischen Texte generiert, die mit menschlichen Schriftstellern vergleichbar sind, und komplexe physikalische Probleme wie die Proteinfaltung gelöst. Wir haben gerade erst begonnen, an der Oberfläche dessen zu kratzen, was derartige KI leisten kann.
Für Vectra AI, Anbieter von Cybersicherheit auf Basis künstlicher Intelligenz, nehmen drei Experten die Entwicklung künstlicher Intelligenz im vergangenen Jahr unter die Lupe: Christopher Thissen (Senior Data Scientist, Vectra AI), Ben Wiener (Data Scientist, Vectra AI) und Sohrob Kazerounian (Senior Data Scientist, Vectra AI).
Das Jahr 2020 hat auch einen Einblick gegeben, wie sehr KI beginnt, in den Alltag einzudringen. Es scheint wahrscheinlich, dass wir in den nächsten Jahren regelmäßig (und unwissentlich) KI-generierte Texte in unseren Social Media Feeds, in der Werbung und in den Nachrichten sehen werden. Die Auswirkungen des Einsatzes von KI in der realen Welt werfen wichtige Fragen über den ethischen Einsatz von KI auf. Es gibt allen Grund zu der Annahme, dass KI Verzerrungen in den Trainingsdaten verstärken könnte. Da KI nun auch bei Kreditanträgen, bei der Strafverfolgung und in anderen Bereichen zum Einsatz kommt, war die Notwendigkeit, diese Vorurteile zu verstehen und zu beseitigen, noch nie so groß. Auch in diesem Jahr haben wir einige große Geschichten über die Ethik der KI gesehen.
GPT-3: KI-generierter Text
Die vielleicht größte Aufmerksamkeit im Jahres 2020 kam dem GPT-3-Modell von OpenAI zuteil. GPT-3 (Generative Pretrained Transformer 3) ist eine KI, die Text verstehen und generieren kann. Die Fähigkeiten dieser KI sind beeindruckend. Erste Anwender haben die KI dazu gebracht, Trivia-Fragen zu beantworten, Fiktion und Poesie zu erstellen und einfache Webseiten aus schriftlichen Anweisungen zu generieren. Am meisten beeindruckend ist vielleicht, dass Menschen nicht zwischen Artikeln, die von GPT-3 geschrieben wurden, und solchen, die von Menschen geschrieben wurden, unterscheiden können. So schaffte es kürzlich ein KI-generierter Artikel an die Spitze von HackerNews, einer beliebten Technologie-Nachrichtenseite, ohne dass die meisten Benutzer bemerkten, dass der Inhalt künstlich generiert wurde.
GPT-3 verwendet eine Technologie namens Attention, die es der KI ermöglicht, zu lernen, auf welche Teile des Textes sie sich konzentrieren soll, z. B. auf Substantive und Verben. Obwohl es diese Aufmerksamkeitstechnologie schon seit einigen Jahren gibt, scheinen die neuen Fähigkeiten von GPT-3 in erster Linie aus einer bloßen Vergrößerung des Netzwerks zu resultieren. Das neue Modell hat erstaunliche 175 Milliarden Parameter, mehr als zehnmal so viele wie frühere Sprachmodelle. Die Fähigkeiten des Modells lassen vermuten, dass die Grenzen der der KI zugrundeliegenden Transformator-Architektur noch nicht erreicht sind. Tatsächlich haben jüngste Arbeiten erste Erfolge auch bei der Bilderzeugung gezeigt.
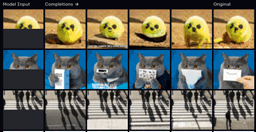
Bild 1: Bilder, die von einer modifizierten Version von GPT-3 erzeugt wurden, die Pixel statt Wörter vorhersagt.
Die unheimliche Fähigkeit von GPT-3, auf menschenähnliche Weise zu schreiben und zu reagieren, hat einige Diskussionen über die Intelligenz dieser KI ausgelöst. Trotz seiner Fähigkeit, überzeugende Texte zu generieren, versteht GPT-3 die Welt nicht so, wie es Menschen tun. Stattdessen sagt die KI einfach das nächste Wort voraus. Dies funktioniert gut bei Themen, über die Menschen bereits ausführlich geschrieben haben, aber das Wissen der KI lässt sich nicht auf neue Informationen übertragen, wie es das menschliche Wissen tut.
Die KI kann zum Beispiel keine einfachen Fragen des gesunden Menschenverstands beantworten, wie zum Beispiel, ob ein Bleistift schwerer ist als ein Toaster. Da es (offensichtlich) nicht genügend Text gibt, der die Eigenschaften von Bleistiften und Toastern vergleicht, kann die KI keine sinnvolle Antwort vorhersagen. Tatsächlich weiß die KI nicht, was ein Bleistift ist, sondern sie weiß nur, welcher Text das Wort Bleistift tendenziell umgibt. Der KI fehlt ein derartiger gesunder Menschenverstand vielleicht gerade deshalb, weil dies die Art von Dingen sind, über die es sich nicht zu schreiben lohnt.
Vermutlich sind diese Themen auch nicht lesenswert, so dass es praktisch gesehen weniger wichtig sein dürfte, dass GPT-3 Probleme mit diesen Fragen hat. Vielmehr geht es darum, dass GPT-3 trotz des ersten Anscheins keine allgemeine Intelligenz besitzt. Stellen Sie sich vor, Sie könnten alle Texte lesen, die jemals erschaffen wurden, wären aber nicht in der Lage, physisch mit der Welt zu interagieren. Sie würden große Wissenslücken haben. Tatsächlich ist die Frage, ob eine KI die Bedeutung von Texten allein erlernen kann, ein wichtiges Forschungsgebiet. Wenn ein Bild mehr als tausend Worte sagt, könnte die Realität mehr wert sein als die 500 Milliarden Wörter im Trainingsset von GPT-3.
Obwohl sich GPT-3 noch nicht der technologischen Singularität nähert, werden sich dieses Modell und andere wie dieses in den kommenden Jahren als unglaublich nützlich erweisen. Unternehmen und Einzelpersonen können über eine API (derzeit in einem privaten Betatest) Zugang zu den Modellergebnissen anfordern. Microsoft besitzt jetzt die Lizenz für GPT-3, und andere Gruppen arbeiten daran, ähnliche Ergebnisse zu erstellen. Ich gehe davon aus, dass wir bald eine Vielzahl neuer Funktionen im Zusammenhang mit KI sehen werden, die Sprache verstehen.
AlphaFold: Proteinfaltung
Außerhalb der natürlichen Sprachverarbeitung gab es 2020 auch wichtige Fortschritte in der Biotechnologie. Gleich zu Beginn des Jahres gab es einen schnellen und zeitnahen Fortschritt bei mRNA-Impfstoffen. Im Laufe des Jahres erwiesen sich diese in klinischen Studien als hochwirksam. Zum Jahresende gab es noch einen weiteren Paukenschlag. AlphaFold von DeepMind scheint ein riesiger Schritt nach vorn zu sein, diesmal im Bereich der Proteinfaltung.
Proteine sind für das Leben absolut essentiell. Sie bilden die Maschinerie, die die DNA repliziert, ermöglichen die zelluläre Signalübertragung, erleichtern chemische Reaktionen und sorgen sogar für die physische Struktur der Zellen. Ein Protein ist ein Polymer, eine Kette von Einheiten, die Aminosäuren genannt werden. Es klingt fast so, als könnte man ein Protein einfach anhand der Sequenz der Aminosäuren verstehen, aus denen es besteht. Es stellt sich jedoch heraus, dass die Sequenz nur ein kleiner Teil des Puzzles ist. Wenn sich ein Protein in seiner natürlichen Umgebung befindet, kleben verschiedene Teile der Kette aneinander, wodurch sich das Molekül in eine komplexe Form faltet. Diese dreidimensionale Struktur ist von entscheidender Bedeutung für das Verhalten des Proteins. Leider ist diese gefaltete Struktur in vielen Fällen sowohl experimentell schwer zu finden als auch schwer aus der Aminosäuresequenz vorherzusagen.
In diesem Herbst trat die neueste Version von AlphaFold in einem alle zwei Jahre stattfindenden Wettbewerb zur Vorhersage der Proteinfaltung, dem CASP Assessment, gegen andere moderne Methoden an. In diesem Wettbewerb wurden Algorithmen mit der Aufgabe betraut, Aminosäuresequenzen in Proteinstrukturen umzuwandeln und wurden anhand des Anteils der Aminosäurepositionen, die das Modell innerhalb einer bestimmten Spanne korrekt vorhersagt, beurteilt. In der anspruchsvollsten Kategorie „Free-Modeling“ war AlphaFold in der Lage, die Struktur von ungesehenen Proteinen mit einem Medianwert von 88,1 vorherzusagen. Der nächstbeste Prädiktor im diesjährigen Wettbewerb erreichte 32,4 Punkte. Dies ist ein erstaunlicher Sprung nach vorne.

Aus rechnerischer Sicht ist die Vorhersage der Proteinfaltung notorisch schwierig. Eine berühmte Schätzung besagt, dass sich ein typisches Protein in unvorstellbare 10300 plausible Konformationen falten könnte. Zum Vergleich: Es gibt nur etwa 1.080 Atome im bekannten Universum. AlphaFold griff dieses beängstigende Problem an, indem es ein tiefes neuronales Netzwerk auf öffentlich verfügbaren Datensätzen bekannter Proteinstrukturen trainierte. Das Team von DeepMind hat noch keine technischen Details ihres Ansatzes veröffentlicht, aber einige grundlegende Fakten mitgeteilt. AlphaFold verwendet einen Deep-Learning-Ansatz, um vorherzusagen, welche Aminosäuren in einer Kette nahe beieinanderliegen werden, und verwendet dann ein separates Modell, um die Struktur auf der Grundlage dieser Näherungsvorhersagen zu lösen. Wie OpenAIs GPT-3 wissen wir, dass AlphaFold den sogenannten Aufmerksamkeitsmechanismus nutzt, der es dem Modell ermöglicht, zu lernen, welche Teile der Eingabe füreinander relevant sind.
In Zukunft können Wissenschaftler Modelle wie AlphaFold nutzen, um ihre Forschung zu Krankheiten und Genetik zu beschleunigen. Vielleicht werden wir Ende 2021 die Technologie feiern, die solche Arbeiten ermöglicht haben.
Deep Learning demokratisieren
Wie bereits erwähnt, erweist sich Deep Learning (die primäre Methode, die vielen modernen KIs zugrunde liegt) in so unterschiedlichen Bereichen wie Biologie und natürlicher Sprache als nützlich. Die Bemühungen, Deep Learning für Fachleute und Praktiker zugänglicher zu machen, beschleunigen die Einführung von KI in vielen Bereichen.
FastAI ist ein hervorragendes Beispiel für diese Bemühungen. FastAI besteht aus einem Online-Kurs, einer Python-Bibliothek und einem Lehrbuch und richtet sich an Leute mit etwa einem Jahr Python-Programmiererfahrung und Mathematik auf Highschool-Niveau. Die Lehrphilosophie des Kurses ist beispielorientiert und motiviert durch frühe Erfolge zum Weiterlernen. Schon in der ersten Lektion bauen die Studenten eine moderne KI. Frühere Absolventen des FastAI-Kurses haben internationale Wettbewerbe für maschinelles Lernen gewonnen, Angebote von Top-Unternehmen erhalten und gemeinnützige Organisationen für maschinelles Lernen gegründet. Die FastAI-Bibliothek verwendet standardmäßig Best Practices und ist derzeit auf bild- und natursprachbezogene Aufgaben fokussiert. Eine neue Version der Bibliothek wurde zusammen mit dem Buch dieses Jahr veröffentlicht.
Die Demokratisierungsbemühungen sind nicht auf Programmierer beschränkt. Jeder, der über einen Internetanschluss verfügt, kann nun ein realistisches, aber komplett gefälschtes Foto eines menschlichen Gesichts erzeugen. Eine ähnliche Technologie wurde bereits verwendet, um realistischere – und schwieriger zu entdeckende – gefälschte Social-Media-Accounts in Desinformationskampagnen zu erstellen, einschließlich einiger im Vorfeld der US-Wahl 2020. Und OpenAI plant, die Fähigkeiten von GPT-3 über eine vergleichsweise einfach zu bedienende API für geprüfte Nutzer verfügbar zu machen. Es besteht die berechtigte Sorge, dass die Deep-Learning-Technologie mit zunehmender Zugänglichkeit auch leichter als Waffe eingesetzt werden kann.
Aber die Kopplung von KI mit menschlichen Experten kann auch zum Guten genutzt werden. Domänenexperten können die KI auf wirkungsvolle, lösbare Probleme lenken und diagnostizieren, wenn die KI voreingenommen ist oder falsche Schlussfolgerungen gezogen hat. Die KI ist in der Lage, enorme Datenmengen schnell zu verarbeiten (manchmal mit höherer Genauigkeit als Menschen), was Analysen billiger und schneller macht und Erkenntnisse zutage fördert, die sonst vielleicht unerreichbar wären. Benutzerfreundliche Tools, APIs und Bibliotheken erleichtern die Einführung von KI, vor allem in Bereichen, in denen bereits etablierte Techniken wie die Bildklassifizierung genutzt werden können. In der Biologie zum Beispiel ist die Zahl der Publikationen, in denen Deep Learning erwähnt wird, in den letzten Jahren von einigen hundert auf mehrere tausend gestiegen. Kurzfristig werden wir wahrscheinlich weiterhin eine rasche Einführung von KI-Techniken in einer Reihe von Bereichen erleben.

KI-Ethik
Eine der interessanten Folgen der immer leichteren Zugänglichkeit von KI- und ML-Systemen ist die daraus resultierende Verschiebung der Prioritäten auf dem Gebiet der KI-Ethik. In der nicht allzu fernen Vergangenheit, als maschinelle Black-Box-Lernalgorithmen bei Aufgaben wie Computersehen, Spracherkennung und Sprachverständnis noch nicht so gut funktionierten, waren die moralischen Rätsel und ethischen Dilemmata, die von KI-Ethikern aufgeworfen wurden, von praktischen Überlegungen eher abgekoppelt. Beispiele dafür sind frühe Diskurse wie Isaac Asimovs Three Laws of Robotics, die die Möglichkeit von Robotern als moralische Agenten mit einer Art Kant'scher deontologischer Ethik verbanden, bis hin zu Rokos Basilisk, einem Gedankenexperiment, in dem eine zukünftige KI die Menschen bestraft, die nicht geholfen haben, sie ins Leben zu rufen. Zu Asimovs Ehrenrettung sei gesagt, dass die Drei Gesetze der Robotik nicht nur in der Mitte des letzten Jahrhunderts geschrieben wurden, sondern auch als Science-Fiction gedacht waren.
Nichtsdestotrotz wurde solchen Themen bis zur kürzlich erfolgten kommerziellen Realisierbarkeit und weit verbreiteten Anwendung von KI- und ML-Systemen eine übergroße Aufmerksamkeit und Verehrung innerhalb des Feldes zuteil. Fragen, die andernfalls als einfache juristische Angelegenheiten in Bezug auf neue Technologien behandelt worden wären, wurden als tiefgreifende Fragen zur Philosophie der Ethik behandelt, einfach nur, weil sie etwas mit KI zu tun hatten. Zum Beispiel führten Diskussionen über die Haftung bei Unfällen mit selbstfahrenden Autos zu einer Fülle von Vergleichen mit dem philosophischen Trolley-Problem. Obwohl unausgesprochen, schwankten diese Vergleiche oft zwischen der Andeutung, dass entweder empfindungsfähige KI-Fahrer eines Tages Werturteile darüber fällen würden, wer zu töten ist, oder umgekehrt, dass Ingenieure bald einen Code schreiben würden, der den relativen Wert von einem Leben gegen fünf abwägt. Es war nie klar, warum irgendetwas davon als etwas Anderes behandelt werden sollte als das Versagen eines komplexen Bremssystems eines Autoherstellers. Es ist ebenso unklar, was die einzigartigen ethischen Dimensionen in Bezug auf KI-Waffensysteme sind, die die falschen Menschen töten, oder KI-Algorithmen, die den Aktienmarkt zum Absturz bringen. Diese gelten nicht gleichermaßen für Situationen, in denen (zum Beispiel) ein menschlicher Drohnen-Operator die falsche Person tötet oder ein menschlicher Aktienhändler versehentlich den Markt zum Absturz bringt.
Was das Feld der KI-Ethik im Jahr 2020 auszeichnet, ist nicht eine einzelne Errungenschaft oder ein Durchbruch, sondern vielmehr die schiere Menge an Arbeit, die geleistet wurde, um die Aufmerksamkeit auf Themen von unmittelbarem Interesse neu auszurichten und zu konzentrieren. Dazu gehören Fragen, die vom Umgang mit rassistischen und geschlechtsspezifischen Vorurteilen in Datensätzen bis hin zu Ungerechtigkeiten reichen, die sich aus schlecht bezahlter Gig-Arbeit ergeben, die eben jene Daten kennzeichnet, die zum Trainieren von Algorithmen verwendet werden. Einige dieser Probleme werden nun durch die zunehmende Interaktion mit KI-Systemen konfrontiert. Die Fernlehre hat zum Beispiel zum Einsatz von Prüfungssoftware geführt, die sich auf Gesichtserkennung stützt, um Betrug zu verhindern, aber zu schrecklichen Szenarien geführt hat, in denen farbige Studenten gezwungen sind, Prüfungen mit hellen Lichtern zu absolvieren, die die ganze Zeit auf ihre Gesichter scheinen, nur um nicht des Betrugs beschuldigt zu werden. Dies sind die gleichen Arten von Gesichtserkennungsalgorithmen, die in China verwendet wurden, um die uigurische Bevölkerung zu verfolgen. Sogar bei medizinischen Geräten, von denen man annehmen könnte, dass sie strengen Testverfahren unterliegen, hat sich gezeigt, dass sie bei schwarzen Patienten eine höhere Fehlerquote aufweisen als bei weißen.
Einige dieser Probleme wurden durch die Zunahme kommerzieller Anwendungen, die auf KI basieren, aufgedeckt. Der andere treibende Faktor war eine kleine, aber engagierte Gruppe von Forschern, oft aus Gruppen, die in der breiteren KI-Gemeinschaft unterrepräsentiert sind. Diese schlugen nicht nur wegen dieser ethischen Bedenken Alarm, sondern drängten auch auf eine größere Vielfalt und Repräsentation im Feld selbst. An dieser Front wurden Fortschritte gemacht. Die zunehmende Präsenz von Affinitätsgruppen auf führenden KI-Konferenzen und die Bestrebungen, die Kriterien für das Sponsoring und die Verbindungen zu verschiedenen Unternehmen zu bewerten, haben die ethischen Mängel der KI stärker ins Bewusstsein gerückt (z.B. durch die Prüfung von antimuslimischen Vorurteilen in Sprachmodellen). An diesem Punkt fühlen sich auch Mainstream-Persönlichkeiten außerhalb des Bereichs der KI-Ethik veranlasst, sich einzumischen, wie z. B. Spieler der Boston Celtics, die eine Regulierung der Gesichtserkennung gefordert haben.
Trotz aller Fortschritte, die bis jetzt gemacht wurden, bleibt ein großer Kampf. Anfang Dezember feuerte Google seinen Co-Leiter für ethische KI, Timnit Gebru. Während Sie die ganze Geschichte in Gebru's eigenen Worten hier nachlesen können, war die Nachricht für die breitere Ethical AI Community sehr beunruhigend. Dies gilt nicht nur, weil Gebru versucht hat, eine Forschungsstudie über die ökologischen Folgen des Trainings von Sprachmodellen in großem Maßstab (die für Googles Geschäft von zentraler Bedeutung sind) und die Probleme hinsichtlich mangelnder Diversität zu veröffentlichen, die als Ergebnis des Überprüfungsprozesses aufgedeckt wurden. Der Vorfall wird auch Fragen darüber auf, wie sich die akademische Forschungscommunity zur Industrie verhalten sollte.
Nichtsdestotrotz legen die Errungenschaften in diesem aufkeimenden Feld den Grundstein dafür, für wen und wofür KI eingesetzt werden sollte. Zumindest müssen wir hoffentlich nicht mehr erklären, warum Sie sich keine Sorgen um Rokos Basilisken machen müssen.
Blick in Richtung 2021
Zu Beginn des Jahres 2020 äußerten einige Forscher die Befürchtung, dass die KI-Forschung bald in einen weiteren Winter eintreten könnte, in dem der Fortschritt zum Stillstand kommt und sowohl das Interesse als auch die Finanzierung versiegen. Während die Neuartigkeit und Aufregung rund um Deep Learning in der Tat nachlassen könnte, ist es sicherlich interessant festzustellen, dass zwei der aufregenderen Durchbrüche im Jahr 2020 GPT-3 und AlphaFold waren, die beide bestehende theoretische Ansätze nutzten, aber die praktischen Anwendungen von KI-Algorithmen in ihren jeweiligen Bereichen erheblich vorantrieben. Im Fall von GPT-3 wurden die Verbesserungen durch eine erhebliche Vergrößerung des Modells erzielt (mit entsprechendem Anstieg der Datenanforderungen und Trainingskosten), während AlphaFold mit anderen Berechnungsmodellen kombiniert wurde, die zusammen den Stand der Technik erreichten. Wir vermuten, dass sich der Fokus in Zukunft darauf verlagern wird, das Lernen aus kleineren Datenmengen zu ermöglichen und gleichzeitig die Generalisierbarkeit und Interpretierbarkeit zu verbessern, um KI-Modelle praktikabler zu machen.
Menschliche Domänenexperten werden auch weiterhin eine wichtige, wenn auch andere Rolle spielen, da die Demokratisierungsbemühungen die KI-Fähigkeiten in neue Bereiche vorantreiben. Da diese Veränderungen die Landschaft, in der KI eingesetzt wird, und die Methoden, mit denen wir mit solchen Systemen interagieren, weiter verändern, werden wir wahrscheinlich auch weiterhin einen Fokus auf pragmatische Probleme mit realen gesellschaftlichen Auswirkungen und anhaltende Diskussionen über die Rolle von KI in der Gesellschaft sehen.
In jedem Fall scheinen praktische Anwendungen noch erheblichen Spielraum zu haben, bevor sie die verfügbaren theoretischen Fortschritte ausschöpfen. Und im Gegensatz zu früheren Jahrzehnten scheint das Eindringen der KI in die Gesellschaft und das Versprechen erreichbarer pragmatischer Lösungen den Fortschritt der KI in absehbarer Zukunft aufrechtzuerhalten.
www.vectra.ai