

Offengelegte Datenbanken zeigen, wie Angreifer KI-Agenten Ziele vorgeben und sie weitgehend selbstständig nach Lücken suchen und angreifen lassen.
KI-Angriffe
ARTEX: Check Point findet über 1.600 offene Angriffs-Panels
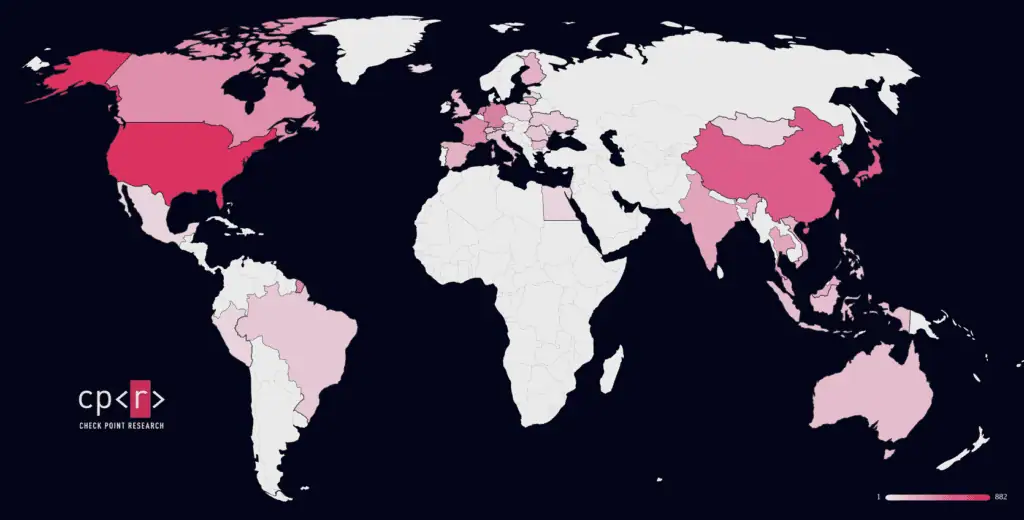
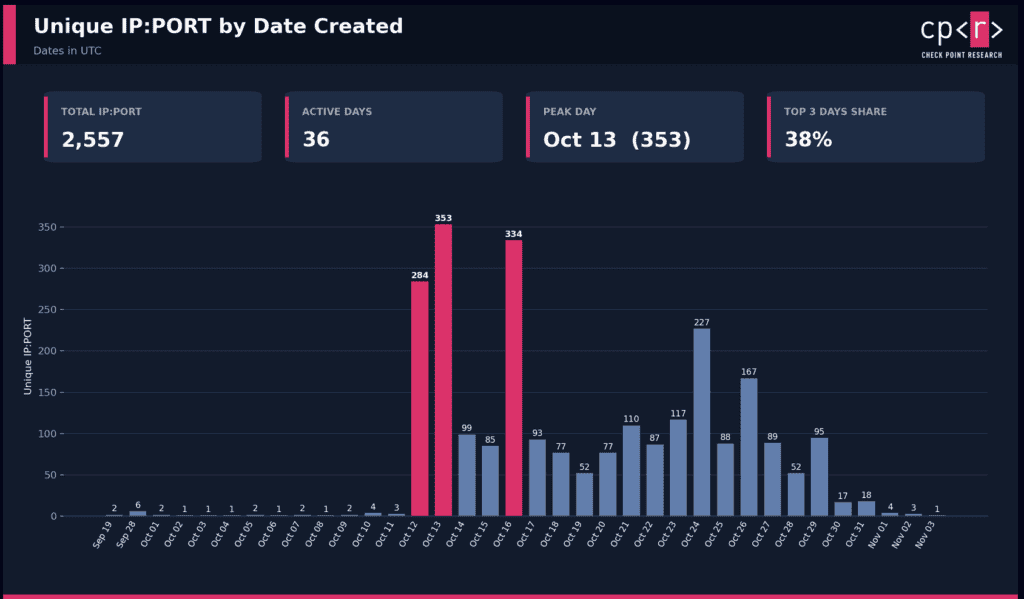
Check Point Research (CPR) hat untersucht, wie Kriminelle die KI-Plattform für Penetrationstests ARTEX bei realen Angriffen einsetzen. Die Forscher fanden 2.557 Systeme, auf denen aktuell oder früher Bedienoberflächen von ARTEX liefen. 1.608 davon waren zum Zeitpunkt der Untersuchung aktiv und öffentlich erreichbar. Weitere Installationen dürften hinter Firewalls oder in lokalen Netzwerken betrieben werden.
ARTEX wurde ursprünglich entwickelt, damit Sicherheitsteams eigene oder freigegebene Systeme testen können. Die Plattform verbindet große Sprachmodelle mit mehreren KI-Agenten, die Tests planen, Sicherheitswerkzeuge ausführen, Schwachstellen untersuchen und Ergebnisse dokumentieren. Nachdem ARTEX bei Angriffen auf südkoreanische Banken aufgefallen war, führte der Entwickler das Projekt nicht mehr quelloffen weiter. Über Forks und Sicherungskopien ist die Software jedoch weiter verfügbar, darunter der Ableger AntiFox.
Agenten arbeiten weitgehend allein
Zehn falsch konfigurierte Installationen legten ihre vollständigen Datenbanken offen. Daraus konnte CPR ablesen, welche Modelle die Angreifer nutzten, welche Anweisungen sie gaben und welche Schritte die Agenten selbstständig ausführten. Demnach legten die Betreiber meist nur ein Ziel fest und überließen die Arbeit den Agenten. Menschen griffen vor allem ein, um den Fortschritt zu prüfen, nachzufragen, ob ein Ziel kompromittiert wurde, oder Prioritäten zu ändern. In einer Kampagne gegen Kryptowährungsdienste führten 292 Ziele zu 230 Befunden und 400.791 Meldungen der Agenten, ohne dass die Betreiber nach der Festlegung der Ziele weitere Eingaben machten.
Wechsel zu weniger restriktiven Modellen
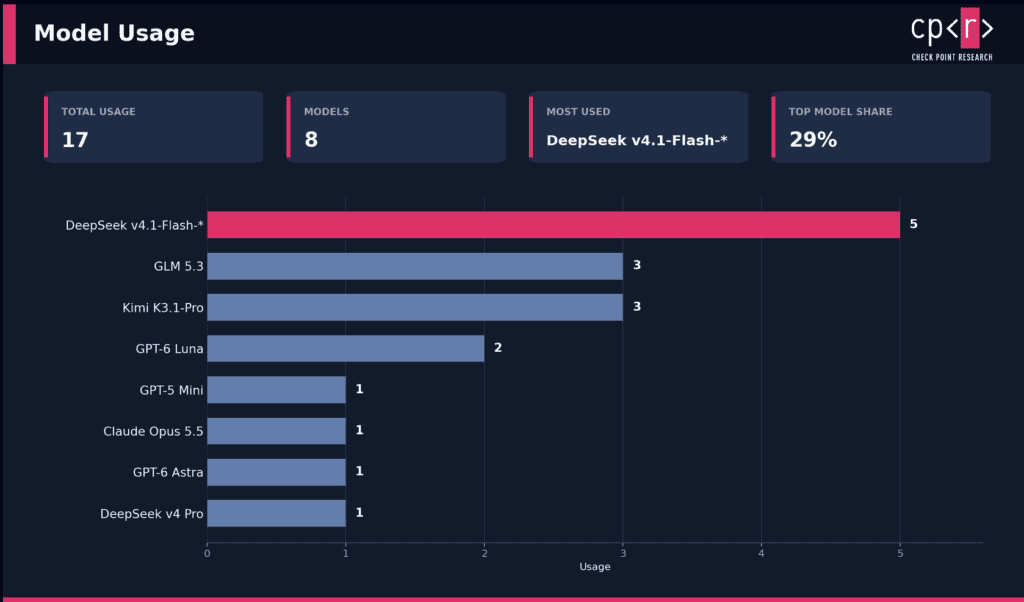
In den untersuchten Installationen dominierten chinesische KI-Modelle, am häufigsten aus der Familie DeepSeek Flash. Auf drei Instanzen waren US-Modelle eingerichtet. Schutzmechanismen griffen laut CPR nur beim Modell Opus 5.5 von Anthropic. Daraufhin wechselte der Betreiber zu weniger restriktiven chinesischen Modellen. CPR folgert, dass Angreifer Modelle gezielt nach Leistung, Kosten und Einschränkungen auswählen.
Ziele waren Dienste für Kryptowährungen und digitale Vermögenswerte, Plattformen für Online-Glücksspiel, Zahlungsdienste, außerbörslicher Kryptohandel und Graumarkt-Dienste zum Signieren von iOS-Apps. Die Angreifer wollten etwa Kryptowährungen und Code-Signing-Zertifikate stehlen, Spielkonten übernehmen oder Glücksspielseiten mit Überlastungsangriffen lahmlegen. Ausgenutzt wurden unter anderem schwache oder fest einprogrammierte Passwörter, fehlende Authentifizierung, unsichere direkte Objektreferenzen und Lücken zur Ausführung von Code aus der Ferne.
Viel Aufwand, kein Gewinn
Autonomie führt laut CPR nicht automatisch zum Erfolg. In der Kryptowährungs-Kampagne verarbeiteten die Agenten 167,5 Millionen Tokens und fanden mehrere Schwachstellen, darunter Codeausführung aus der Ferne und ungeschützte Datenbanken. Finanziellen Gewinn erzielte der Angreifer dennoch nicht. CPR erwartet jedoch, dass sich das ändert, und rät Sicherheitsteams, selbst mit KI schneller auf Vorfälle zu reagieren. Ähnliche Beobachtungen hatte Acronis zur Kampagne BOSSAI veröffentlicht, bei der kommerzielle Modelle offensive Aufgaben verweigerten und der Angreifer auf lokal betriebene Modelle auswich.
(red/Check Point Research)


