KI-Kosten bestehen aus Lizenzgebühren plus Verbrauch, verteilt über mehrere Anbieter und oft ausgelöst von Agenten im Hintergrund. Ein pauschaler Kostendeckel hilft da wenig.
Wenn der Token-Zähler läuft
KI-Kosten im Griff: Kennzahlen und Rollen für IT und Finance
Wer KI-Ausgaben steuern will, braucht die richtigen Kennzahlen sowie klare Rollen zwischen IT und Finance.
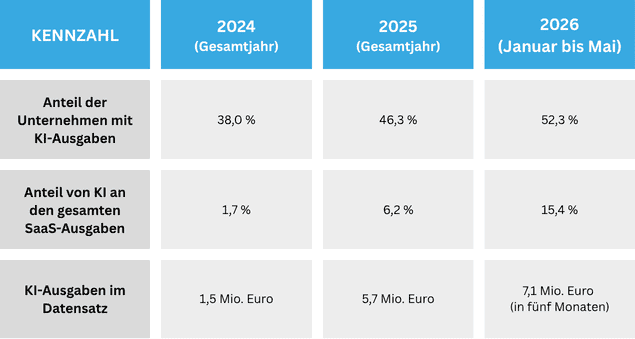
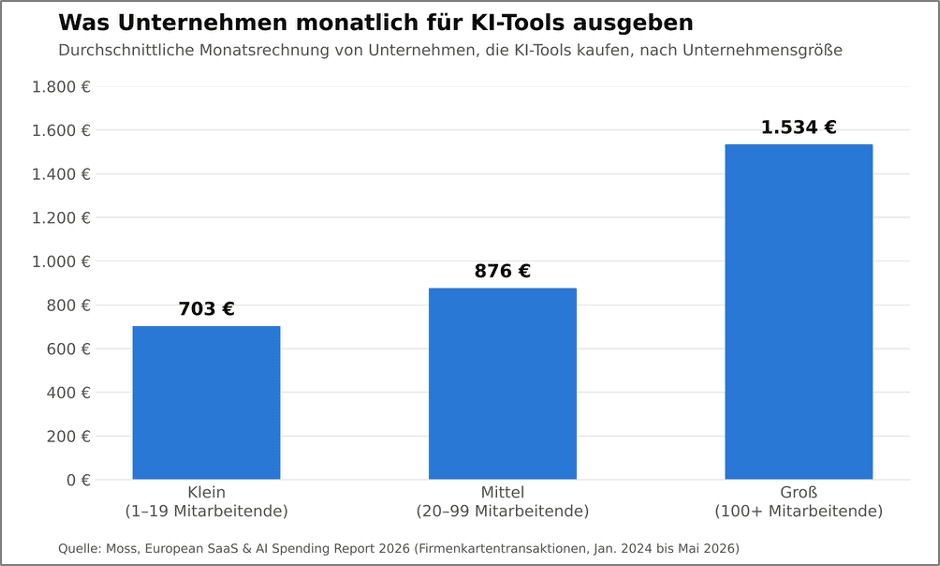
Für die meisten Finanzabteilungen waren KI-Kosten bis vor Kurzem eine Randnotiz in der Softwareliste. Das hat sich schnell geändert. Laut unserem European SaaS & AI Spending Report 2026 ist KI inzwischen die drittgrößte Softwarekategorie – mit einer stark steigenden Tendenz. Für den Report haben wir Kartentransaktionen europäischer Unternehmen im Gesamtvolumen von über 302 Millionen Euro ausgewertet. Der Report bildet damit ab, was Unternehmen per Firmenkarte bezahlen, und nicht zwingend jede KI-Ausgabe. Der KI-Anteil an den Ausgaben für Software-as-a-Service (SaaS), also Software aus der Cloud im Abo, stieg im Vergleich der Monate Januar bis Mai von 5,1 Prozent im Jahr 2025 auf 15,4 Prozent 2026. Die KI-Ausgaben lagen von Januar bis Mai 2026 um 309 Prozent über dem Vorjahreszeitraum. In diesen fünf Monaten haben die Unternehmen bereits mehr für KI ausgegeben als im gesamten Vorjahr.
Ich halte dieses Wachstum für eine gute Nachricht. Unternehmen probieren aus, vieles davon wird sich auszahlen. Für die Finance-Funktion ist diese Entwicklung trotzdem unbequem, denn KI-Kosten verhalten sich anders als jede Software, die wir bisher budgetiert haben.
Tabelle 1: KI-Ausgaben europäischer Unternehmen 2024 bis 2026
KI-Kosten: Warum die Rechnung zu spät kommt
Zu den festen Lizenzen für Sprachmodelle wie ChatGPT, Claude oder Gemini sowie für Spezialtools wie DeepL oder Perplexity kommt die Abrechnung nach Verbrauch, gemessen in Token, den Texteinheiten, die ein Modell verarbeitet. Was eine Anfrage kostet, hängt vom Modell ab, von der Länge der Eingabe und davon, wie oft ein Vorgang wiederholt wird. Auslöser sind längst nicht mehr allein die Mitarbeitenden. Agenten und automatisierte Workflows rufen im Hintergrund Modelle auf, oft mehrmals hintereinander. Dazu bleibt kaum ein Unternehmen bei einem Anbieter. Von den Firmen im Report, die OpenAI und Anthropic ausprobiert haben, nutzen 67 Prozent beide weiter. Jedes Dashboard zeigt aber nur seinen eigenen Teil. Die Gesamtsumme sieht Finance erst auf der Rechnung, wenn das Geld längst ausgegeben ist.
Bei Agenten lohnt deshalb der Blick auf den ganzen Ablauf statt auf den einzelnen Aufruf. Ein Workflow führt im Hintergrund oft eine Kette von Modellaufrufen aus, wiederholt Schritte und bindet zusätzliche Tools ein. Über viele Prozessschritte summiert sich das schnell. Dazu kommen Kosten, die gar nicht auf der Token-Abrechnung des Modellanbieters stehen: Abfragen externer Schnittstellen, Retrieval-Augmented Generation (RAG), bei der sich ein Agent Inhalte aus internen Wissensquellen holt, die Vektordatenbanken dahinter sowie die Infrastruktur, auf der die Agenten betrieben werden. Was ein Agent kostet, zeigt deshalb erst die Rechnung über den gesamten Workflow.
KI-Budget: Warum ein pauschaler Deckel scheitert
Der erste Reflex vieler Finanzabteilungen ist ein Budgetlimit für das ganze Unternehmen. Ich verstehe den Impuls, halte ihn aber für den falschen Weg. So ein Deckel stoppt im Zweifel den Kundenservice-Workflow, der Umsatz sichert, genauso wie den Testlauf, den niemand mehr braucht. Außerdem verdecken Durchschnittswerte, wie ungleich KI-Kosten verteilt sind. Bei kleinen Unternehmen zahlt die Hälfte weniger als 46 Euro im Monat an OpenAI, das ausgabenstärkste Unternehmen dieser Größe dagegen 117.000 Euro allein für die API, also den direkten Zugriff auf die Modelle über eine Programmierschnittstelle.
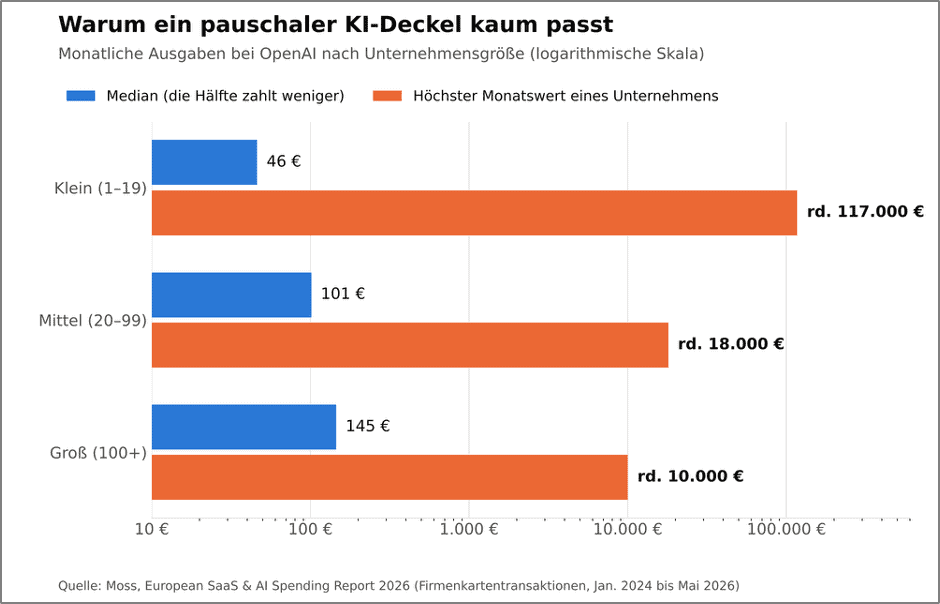
Eine Grenze, die für alle gilt, passt so für fast niemanden. Sinnvoller sind Limits dort, wo die Kosten entstehen, also pro Team, API-Key (dem Zugangsschlüssel einer Anwendung) oder Workflow. Bei geschäftskritischen Anwendungen würde ich eher mit Warnschwellen arbeiten als mit einer harten Abschaltung.
KI-Kostensprung erklären: Modellmix, Model Routing und Agenten
Steigt die KI-Rechnung, lautet die erste Frage: warum? Die Euro-Summe allein beantwortet sie nicht. Aussagekräftig wird diese erst, wenn man sie neben die Zahl der Anfragen und den Anteil aktiver Nutzer legt. Steigen Kosten sowie Anfragen parallel, wird schlicht mehr KI genutzt. Wachsen die Kosten bei stabilem Anfragevolumen, hat sich meist der Modellmix verschoben, etwa weil Routineaufgaben über ein teures Premium-Modell laufen. Ein einzelner API-Key mit sprunghaft wachsendem Token-Volumen deutet dagegen oft auf einen Agenten, der in einer Schleife hängt.
Der Modellmix ist zugleich einer der wirksamsten Hebel. Premium-Modelle, lange Kontexte oder wiederholte Versuche treiben die Kosten, günstigere Modelle oder zwischengespeicherte Token senken sie. Bei jeder größeren Kostenposition lohnt deshalb die Frage, ob die Aufgabe diese Leistungsstufe braucht. Einfache Aufgaben wie das Klassifizieren, Zusammenfassen oder Auslesen von Dokumenten erledigen kleinere Sprachmodelle (Small Language Models) oft ebenso gut bei geringeren Kosten. Nur komplexe Aufgaben müssen an die großen Modelle gehen. Diese Verteilung lässt sich auch automatisieren: Beim Model Routing wählt ein System je nach Aufgabe, Qualitätsanforderung und Kosten selbst das passende Modell aus.
Für genau diese Fragen haben wir bei Moss den AI Token Cost Tracker entwickelt. Das kostenlose Tool ist eine lokale Anwendung, die sich direkt mit den Admin-APIs von OpenAI und Anthropic verbindet. Sie läuft auf dem eigenen Rechner, bedient wird sie im Browser. Abgerufen werden Kosten, Anfragen sowie die Nutzung durch die Mitarbeitenden, aufgeschlüsselt nach Produkt, Modell, Team, API-Key oder Workflow. Prompts, Antworten oder hochgeladene Dateien liest der Tracker nicht. Weder die Zugangsschlüssel noch die abgerufenen Daten gehen an Moss. Für die Einrichtung braucht es einen Zugang zu GitHub, die Laufzeitumgebung Node.js sowie ein Terminal. Video-Anleitungen führen auch Nutzer ohne technischen Hintergrund durch die Installation, ein Demo-Modus zeigt das Tool vorab mit Beispieldaten. Weil der Code öffentlich ist, kann die IT vorher prüfen, wie Zugangsschlüssel und Daten behandelt werden. Welche Kennzahlen verfügbar sind, hängt vom Tarif beim jeweiligen Anbieter ab.
AI FinOps: Wer in IT, Fachbereichen und Finance Verantwortung trägt
Wer trägt also die Verantwortung? Meine Antwort: alle, aber in klar getrennten Rollen. Die IT entscheidet in der Regel über Modelle und Architektur, die Fachbereiche über den Einsatz, Finance verantwortet das Budget. Finance muss keine Prompts umschreiben. Die Abteilung sollte aber erkennen, wer das nächste Gespräch führen muss: das Team bei auffälliger Nutzung, die Entwicklung, wenn ein Workflow technische Grenzen braucht.
Damit diese Rollen zusammenspielen, braucht es ein gemeinsames Steuerungsmodell. Das muss kein Unternehmen neu erfinden. Wer seine Cloud-Kosten bereits nach dem FinOps-Ansatz (Financial Operations) steuert, bei dem IT, Fachbereiche und Finance gemeinsam für die Kosten verantwortlich sind, kann viele Verfahren übertragen. Für KI wird dieser Ansatz inzwischen unter dem Begriff AI FinOps diskutiert. Grundlage ist eine einheitliche Erfassung aller KI-Kosten über sämtliche Anbieter hinweg. Darauf bauen die Zuordnung zu Kostenstellen, Teams oder Anwendungen auf, außerdem Budgets mit Warnschwellen je Workflow, eine klar benannte Verantwortung für jede Kostenposition sowie ein fester Rhythmus, in dem Modelle und Workflows auf den Prüfstand kommen.
Zur Steuerung gehören zwei Fragen, die über die Kosten hinausgehen. Die erste betrifft Datenschutz und Compliance: Welche Daten dürfen an welchen Anbieter gehen, welche gesetzlichen oder internen Vorgaben gelten dafür? Wie ernst Finanzabteilungen das nehmen, zeigt unsere Befragung „AI Adoption and the Future of Finance“ unter mehr als 300 Finanzfachleuten: 69 Prozent haben ein KI-Werkzeug wegen Datenschutzbedenken schon einmal gemieden. Die zweite Frage ist die Abhängigkeit von einzelnen Anbietern, ihren Preismodellen sowie Schnittstellen. Wer mehrere Modelle parallel nutzt, kann leichter wechseln. Jeder Wechsel verursacht allerdings Aufwand für Anpassungen an den eigenen Systemen, der in die Rechnung gehört.
KI-ROI messen: Kosten pro Ergebnis und pro erfolgreichem Vorgang
Spätestens im Budgetgespräch kommt die Frage nach dem Nutzen. Mein Vorschlag: KI-Kosten pro Ergebnis rechnen statt als Softwareposten. Was kostet eine automatisch vorkontierte Rechnung, ein beantwortetes Kundenticket, ein geprüfter Vertrag? Diesen Wert stellt man dem bisherigen Aufwand gegenüber, gemessen in Arbeitszeit, Durchlaufzeit oder Fehlerquote. Wichtig ist, die Ausgangslage vor dem Start festzuhalten, sonst fehlt später der Vergleich. Auch die Adoption gehört in die Rechnung, denn kaum genutzte Lizenzen drücken die Rendite der Investition (Return on Invest, ROI oder eben “Return on AI”) ebenso wie ein Agent, der unbemerkt Token verbraucht. Manches zahlt sich zudem erst später aus, etwa schnellere Antworten an Kunden oder ein kürzerer Monatsabschluss. Wer nur auf das nächste Quartal schaut, misst zu früh. Darüber hinaus ist es auch bei den kurzfristigen Erfolgen wichtig, zu analysieren, wie diese in nachhaltig optimierte Workflows überführt werden können – sowohl auf der operativen Seite als auch bei der Modellnutzung.
Die Kosten pro Ergebnis allein greifen allerdings zu kurz. Was wenig kostet, ist noch nicht wirtschaftlich. Liefert ein kleineres Modell mehr Fehler, die jemand im Team nacharbeiten muss, kann es am Ende teurer sein als ein leistungsfähigeres. In die Auswertung gehören deshalb auch Qualität und Genauigkeit, die Quote der Nacharbeit, der Anteil menschlicher Eingriffe sowie die Durchlaufzeit. Am aussagekräftigsten sind die Kosten pro erfolgreich abgeschlossenem Vorgang, etwa pro Rechnung, die ohne Korrektur durch die Buchhaltung läuft. Dazu sollte ein System offen zeigen, welche Fälle es nicht lösen konnte. Eine Liste ungeklärter Positionen mit Begründung hilft dem Team mehr als eine glatte Ausgabe ohne jede Rückfrage.
Für den Einstieg reicht wenig: alle KI-Anbieter erfassen, die Kosten monatlich nach Team und Workflow auswerten und für zwei, drei zentrale Anwendungsfälle die Kosten pro erfolgreich abgeschlossenem Vorgang festhalten. So lässt sich ein KI-Budget begründet erhöhen, statt es vorsorglich zu kappen. Für die nächste Budgetrunde heißt das: erst die Kennzahlen klären, dann das Budget festlegen.