Thought Leadership
RAG oder Fine-Tuning: Welcher Ansatz liefert für Unternehmens-KI wirklich mehr Wert? Ein erweiterter Entscheidungsrahmen mit Einschätzungen von Gartner, Forrester, IDC, KuppingerCole, Eckerson Group und BARC sowie einer Pro-und-Contra-Tabelle für die Praxis.
Der Einsatz von Künstlicher Intelligenz ist für die meisten Unternehmen mittlerweile gesetzt. Die eigentliche Herausforderung beginnt erst danach: Wie bekommt ein Sprachmodell das spezifische Wissen eines Unternehmens vermittelt, ohne dass Kosten, Kontrolle oder Compliance aus dem Ruder laufen? Zwei Techniken dominieren diese Debatte: Retrieval Augmented Generation, kurz RAG, und das Fine-Tuning von Sprachmodellen. Progress Software, ein Anbieter von KI-gestützten Infrastruktur- und Digital-Experience-Lösungen, hat dazu ein Entscheidungsframework mit sieben Fragen vorgeschlagen. Es lohnt sich, dieses Framework um Praxiserfahrungen, Kostenaspekte, Sicherheitsfragen und die Einschätzung unabhängiger Analystenhäuser zu erweitern. Denn mit sieben Fragen allein ist die Entscheidung in der Praxis selten wirklich abgeschlossen.
Zwei Wege, ein Ziel: Wissen ins Modell bringen
RAG verknüpft ein bestehendes Sprachmodell zur Laufzeit mit einer externen Wissensquelle, meist einer Vektordatenbank. Eine Nutzeranfrage wird zunächst mit passenden Dokumentenausschnitten angereichert, bevor das Modell daraus eine Antwort formuliert. Die Parameter des Modells selbst bleiben dabei unverändert, das Unternehmen tauscht lediglich die Wissensbasis aus.
Fine-Tuning geht den umgekehrten Weg: Ein vortrainiertes Modell wird mit kuratierten, unternehmensspezifischen Datensätzen weitertrainiert, wodurch sich seine internen Gewichte dauerhaft verändern. Beide Verfahren adressieren dieselbe Grundschwäche vortrainierter Modelle, nämlich ihr statisches und meist generisches Wissen, gehen dabei aber technisch, organisatorisch und wirtschaftlich sehr unterschiedliche Wege. Der Ansatz geht auf eine Forschungsarbeit von Meta AI aus dem Jahr 2020 zurück und hat sich seither vom akademischen Konzept zu einem festen Bestandteil vieler KI-Architekturen entwickelt.
Der Sieben-Fragen-Kompass in der Praxis
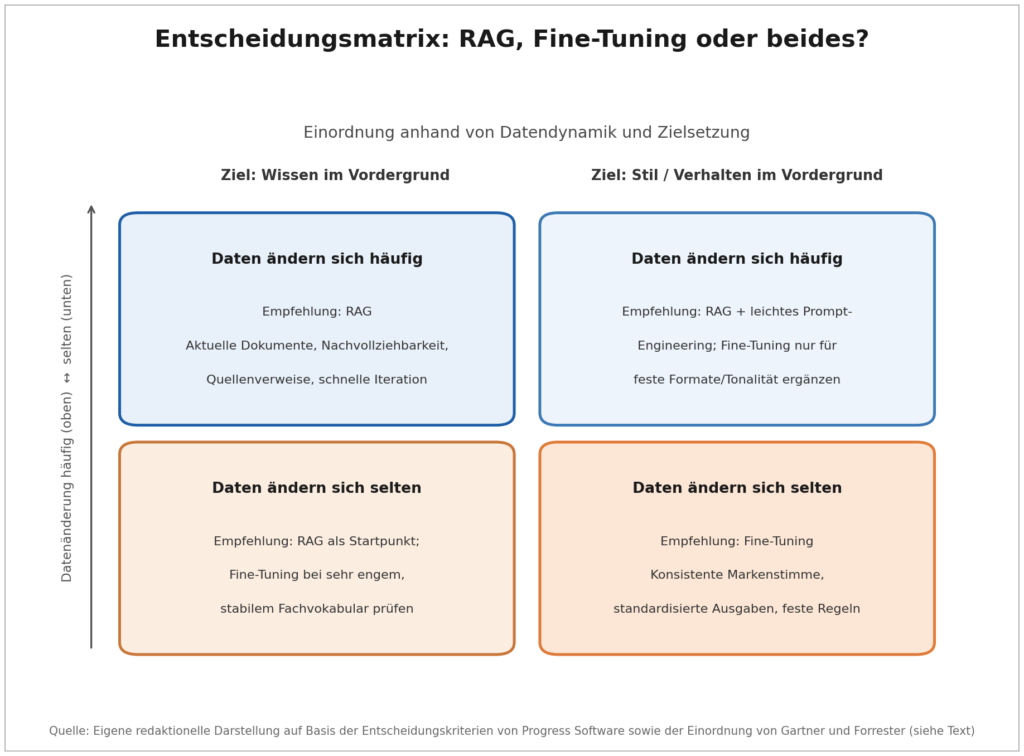
Progress Software schlägt vor, die Entscheidung anhand von sieben einfachen Fragen zu treffen. Ändern sich die Unternehmensdaten häufig, etwa durch neue Produkte oder Richtlinien, spricht das für RAG, weil das System zur Laufzeit auf aktuelle Dokumente zugreift, während Fine-Tuning nach jeder relevanten Änderung einen neuen, kosten- und zeitintensiven Trainingszyklus erfordert. Muss das Modell auf konkrete Dokumente oder Datenquellen verweisen können, ist RAG ebenfalls im Vorteil, da es Antworten mit nachvollziehbaren Quellen unterlegen kann, was ein fein trainiertes Modell in der Regel nicht zuverlässig leistet.
Geht es dagegen vor allem um eine konsistente Markenstimme, einen festen Schreibstil oder ein klar definiertes Antwortverhalten, kann Fine-Tuning für mehr Konsistenz sorgen, wobei sich viele dieser Ziele erfahrungsgemäß bereits mit guten System-Prompts und Beispielkontext erreichen lassen. Fehlt es an Budget und Zeit für wiederkehrende Trainingszyklen, fällt die Wahl meist auf RAG, weil dessen Iterationszyklen kürzer und die Anfangsinvestitionen geringer ausfallen. Sind überprüfbare, quellenbasierte Antworten geschäftskritisch, etwa in regulierten Branchen, bietet RAG einen klaren Vertrauensvorteil. Fine-Tuning wiederum eignet sich für sehr enge, weitgehend statische Fachdomänen mit spezialisiertem Vokabular, etwa in der juristischen Dokumentenerstellung. Und schließlich braucht erfolgreiches Fine-Tuning bereits saubere, strukturierte und gelabelte Trainingsdaten, deren Aufbereitung häufig unterschätzt wird und Wochen bis Monate in Anspruch nehmen kann.
Thomas Schuller, Regional Director DACH bei Progress Software, bringt die zugrunde liegende Beobachtung auf den Punkt: Viele Unternehmen gingen zunächst davon aus, ein Modell müsse zwingend mit den eigenen Daten trainiert werden. In der Praxis zeige sich jedoch, dass RAG-Ansätze bereits einen Großteil der Anforderungen erfüllten, während Fine-Tuning eher als ergänzende Feinjustierung für Tonalität oder ein tieferes Domänenverständnis tauge.

Was der Standardvergleich oft ausblendet
Der Sieben-Fragen-Kompass ist ein guter Einstieg, blendet aber drei Aspekte aus, die in der Praxis häufig über Erfolg oder Misserfolg entscheiden.
Kosten über den gesamten Lebenszyklus: Parametereffiziente Verfahren wie LoRA und QLoRA sowie kleinere Sprachmodelle im Bereich von sieben bis vierzehn Milliarden Parametern haben die reinen Trainingskosten für Fine-Tuning in den vergangenen zwei Jahren deutlich gesenkt. Wer nur die Trainingsrechnung betrachtet, übersieht jedoch, dass RAG eigene laufende Kosten erzeugt: Betrieb der Vektordatenbank, Aktualisierung der Embeddings, Latenz durch den Retrieval-Schritt sowie steigende Token-Kosten bei großen Kontextfenstern. Ein seriöser Kostenvergleich muss daher immer die gesamte Betriebsdauer und nicht nur den ersten Trainingslauf berücksichtigen.
Sicherheit, Governance und der EU AI Act: RAG-Systeme öffnen eine neue Angriffsfläche. Weil Antworten auf Basis abgerufener Dokumente entstehen, können manipulierte oder eingeschleuste Inhalte zu Prompt Injections führen oder sensible Daten unbeabsichtigt offenlegen. Genau diese Kategorie von Bedrohungen adressiert die Analystenfirma KuppingerCole in ihrem aktuellen Marktüberblick zu GenAI-Schutzlösungen (siehe nächster Abschnitt).
Gleichzeitig kann eine sauber dokumentierte Quellenkette bei RAG-Systemen helfen, Nachweispflichten aus dem EU AI Act leichter zu erfüllen, weil sich Antworten bis auf das zugrunde liegende Dokument zurückverfolgen lassen. Fine-Tuning bietet diese Nachvollziehbarkeit naturgemäß nicht, verringert dafür aber die Angriffsfläche, die durch eine externe Wissensbasis entsteht.
Datenschutz und Datenhoheit: Für Unternehmen im DACH-Raum stellt sich zusätzlich die Frage, wo die Vektordatenbank und die Embedding-Pipeline eines RAG-Systems tatsächlich betrieben werden. On-Premises- oder EU-Cloud-Lösungen können hier notwendig werden, sobald personenbezogene oder besonders schützenswerte Unternehmensdaten in die Wissensbasis einfließen. Diese Anforderung betrifft RAG stärker als Fine-Tuning, weil bei RAG die Rohdaten dauerhaft in einer durchsuchbaren Form vorgehalten werden, während sie bei Fine-Tuning nur indirekt in den Modellgewichten aufgehen.
Zur Einordnung der Halluzinationsproblematik lohnt sich ein Blick auf die akademische Herkunft von RAG: Bereits die ursprüngliche Arbeit von Lewis und Kollegen bei Meta AI aus dem Jahr 2020 zeigte, dass die Anbindung an externe Wissensquellen die Verlässlichkeit generierter Antworten verbessert, weil das Modell nicht mehr ausschließlich aus seinem trainierten Gedächtnis schöpfen muss.
Wie stark sich Halluzinationen in einem konkreten Projekt reduzieren lassen, hängt jedoch stark von der Qualität der Wissensbasis und der Retrieval-Logik ab und lässt sich nicht seriös auf eine einzelne, allgemeingültige Prozentzahl verdichten. Wer belastbare eigene Werte braucht, sollte sie über ein Evaluationsset mit den eigenen Fachdokumenten selbst ermitteln.
Was sagen die Analysten?
Ein Blick auf unabhängige Marktbeobachter zeigt, dass RAG sich in der breiten Unternehmenspraxis als bevorzugter Startpunkt etabliert hat, während Fine-Tuning eine wichtige, aber deutlich kleinere Nische bleibt. Wichtig zur Einordnung: Die zitierten Häuser decken bewusst unterschiedliche Fachgebiete ab und sind keine austauschbaren Security-Analysten. Gartner und Forrester analysieren IT-Themen branchenübergreifend, KuppingerCole ist auf Identity, Access und IT-Security spezialisiert, BARC und Eckerson Group kommen aus dem Bereich Business Intelligence und Data Management, und Menlo Ventures ist, wie unten erläutert, kein Analystenhaus, sondern eine Venture-Capital-Marktbeobachtung.
Gartner: Gartner beschreibt RAG in seinem Research-Dokument „Getting Started With Retrieval Augmented Generation“ als praktikablen Weg, um Unternehmenswissen in Sprachmodelle einzubinden, ohne dabei die Kontrolle über proprietäre Daten aufzugeben. Der Einsatz von RAG sei aktuell noch ein Wettbewerbsvorteil, werde aber nach Einschätzung der Analysten in absehbarer Zeit zu einer grundlegenden Kompetenz jedes Unternehmens, das generative KI produktiv nutzt.
Forrester: In der zweiteiligen Studie „Forrester’s Guide To Retrieval-Augmented Generation“ ordnet das Analystenhaus RAG als direkte Antwort auf die Grenzen von Foundation Models bei Genauigkeit, Relevanz und Domänenwissen ein. Forrester beschreibt zudem, wie sich RAG vom reinen Retrieval-Baustein zu einer umfassenderen Plattform mit eigenem Software-Ökosystem entwickelt und damit auch den Weg zu agentenbasierter Automatisierung ebnet.
IDC: Bereits in seiner FutureScape-Prognose für generative KI ging IDC davon aus, dass bis 2025 zwei Drittel der Unternehmen eine Kombination aus generativer KI und RAG einsetzen würden, um domänenspezifisches Self-Service-Wissensmanagement zu ermöglichen, und dass sich dadurch die Entscheidungsqualität in den betroffenen Prozessen um rund die Hälfte verbessern ließe.
KuppingerCole: Der auf Identity, Access und Security spezialisierte Analyst KuppingerCole widmet RAG-Systemen in seinem Leadership Compass zu GenAI-Schutzlösungen ein eigenes Kapitel, weil sie Angriffsflächen wie Prompt Injection, indirekte Injection über manipulierte Dokumente und Datenabfluss eröffnen. Die Analysten sehen in Europa, insbesondere in Deutschland, eine besonders starke Nachfrage nach entsprechenden Schutzmaßnahmen, getrieben durch die Erfahrung mit der DSGVO und die schrittweise Umsetzung des EU AI Act.
Eckerson Group: Der auf Daten- und Analytics-Themen fokussierte Eckerson Group empfiehlt Data- und KI-Verantwortlichen in seiner RAG-Beratung, den Vergleich zwischen selbst gebauten und kommerziellen RAG-Lösungen anhand weniger gezielter Fragen zu strukturieren, etwa zur Kontrolle über die Datenpipeline, zum Wartungsaufwand und zur langfristigen Anbieterabhängigkeit, statt sich allein von Marketingversprechen leiten zu lassen.
BARC: Das auf Business Intelligence und Data Management spezialisierte Analystenhaus BARC kommt in einer 2025 gemeinsam mit dem Datenqualitätsanbieter Ataccama veröffentlichten Studie zu dem Ergebnis, dass 58 Prozent der befragten Organisationen zwar bereits über Data-Observability-Programme verfügen, 42 Prozent den Ergebnissen ihrer KI-Modelle aber weiterhin nicht vollständig vertrauen. Mit wachsendem RAG-Einsatz rücken laut BARC unstrukturierte Datenquellen wie PDFs und lange Dokumente stärker in den Fokus von Data-Governance-Strategien, weil sie klassische Qualitätsprüfungen bislang häufig umgehen. Da es sich um eine anbieterfinanzierte Studie handelt, sollten die Zahlen als Trendindikator und nicht als völlig unabhängige Grundlagenforschung gelesen werden.
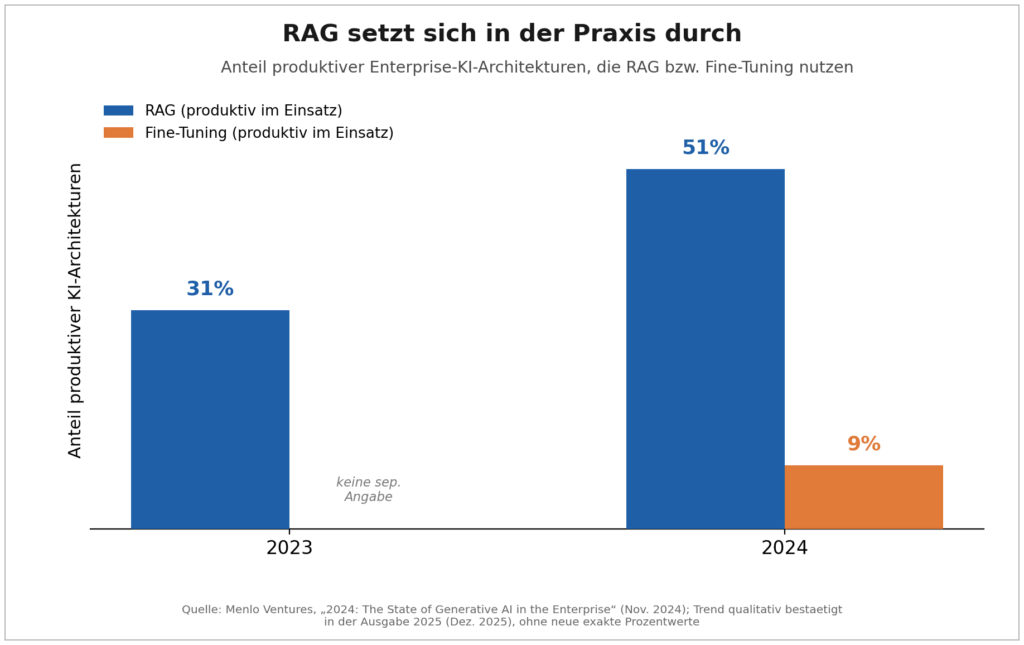
Menlo Ventures: Nicht als klassisches Analystenhaus, sondern als vielzitierte Marktbeobachtung einer Venture-Capital-Gesellschaft ist die jährliche Befragung von Menlo Ventures unter US-Unternehmensentscheidern einzuordnen. Die Ausgabe 2024 zeigt einen deutlichen Trend: Der Anteil produktiver KI-Architekturen, die RAG nutzen, stieg von 31 Prozent im Jahr 2023 auf 51 Prozent im Jahr 2024, während Fine-Tuning nur in 9 Prozent der produktiven Modelle zum Einsatz kam. Die im Dezember 2025 veröffentlichte Folgeausgabe bestätigt diese Rangfolge qualitativ erneut: Prompt-Design bleibt die dominante Technik, RAG folgt an zweiter Stelle, während Fine-Tuning zusammen mit Tool Calling und Reinforcement Learning weiterhin eine Nische bildet, die vor allem von technisch führenden Teams genutzt wird. Eine neue, ebenso präzise Prozentaufteilung wie 2024 veröffentlicht Menlo Ventures in der 2025er-Ausgabe allerdings nicht, sodass 31 zu 9 Prozent beziehungsweise 51 zu 9 Prozent weiterhin die genauesten öffentlich verfügbaren Vergleichswerte sind.
Wie Unternehmen die Entscheidung in der Praxis testen
Unabhängig davon, für welchen Ansatz sich ein Unternehmen letztlich entscheidet, empfiehlt sich vor dem Produktivstart ein strukturierter Testlauf. Bewährt hat sich ein sogenanntes Golden-Test-Set: eine kuratierte Sammlung realer Fachfragen aus dem eigenen Anwendungsfall, zu denen die korrekte Antwort bereits bekannt ist. Anhand dieses Sets lassen sich RAG-Pipeline und feinjustiertes Modell unter identischen Bedingungen vergleichen, etwa hinsichtlich Trefferquote, Antwortzeit und Häufigkeit erkennbarer Falschaussagen.
Wichtig ist dabei, nicht nur die Antwortqualität, sondern auch die Retrieval-Qualität isoliert zu messen, denn eine schwache Antwort kann sowohl an einem ungeeigneten Sprachmodell als auch an einer unzureichenden Trefferliste aus der Vektordatenbank liegen. Ergänzend lohnt sich ein einfacher Red-Team-Test, bei dem gezielt versucht wird, das System über manipulierte oder widersprüchliche Dokumente zu falschen Aussagen zu verleiten. Genau diese Testpraxis deckt sich mit der Empfehlung von KuppingerCole, GenAI-Systeme kontinuierlich auf neue Angriffsmuster zu prüfen, statt sich auf eine einmalige Abnahme vor dem Go-Live zu verlassen. Erst wenn beide Tests zufriedenstellend ausfallen, sollte ein System aus einem Pilotprojekt in den produktiven DACH-Betrieb überführt werden, wo zusätzlich Fragen der Datenresidenz und der Protokollierung gemäß DSGVO zu klären sind.
Eine echte Interviewstudie aus dem deutschsprachigen Raum
Wie nah der oben skizzierte Rahmen an der tatsächlichen Praxis liegt, zeigt eine 2025 am Institut für Informatik der Universität Innsbruck durchgeführte Interviewstudie von Lorenz Brehme, Benedikt Dornauer, Thomas Ströhle, Maximilian Ehrhart und Ruth Breu, vorgestellt auf der Fachkonferenz KDIR 2025. Die Forschenden befragten 13 Praktikerinnen und Praktiker aus Unternehmen unterschiedlicher Größe und Branche, die selbst RAG-Systeme implementiert hatten. Laut Danksagung der Studie zählten unter anderem Vaadin, Akkodis, PPI AG, DeepOpinion sowie weitere Partner aus dem DACH-Raum und Europa zu den beteiligten Unternehmen, wobei die einzelnen Interviewaussagen anonymisiert ausgewertet wurden.
Die Ergebnisse bestätigen die im Analystenteil skizzierte Priorisierung: Auf einer Skala von 0 bis 10 bewerteten die befragten Praktiker Datenschutz und Privatsphäre im Schnitt mit 8,9 Punkten, die Qualität der generierten Antworten mit 8,7 Punkten und Sicherheit mit 8,5 Punkten als wichtigste Anforderungen, während ethische Aspekte und Bias-Vermeidung mit durchschnittlich nur 5,6 Punkten deutlich geringer priorisiert wurden. Zwölf der dreizehn untersuchten Systeme befanden sich zum Befragungszeitpunkt noch unterhalb von Technology Readiness Level 7, also im Prototypen- oder Pilotstadium und nicht im breiten Produktivbetrieb.
Als größte praktische Hürde nannten die Teilnehmenden durchweg die Datenaufbereitung: unstrukturierte Formate wie PDFs, uneinheitliche Chunking-Strategien und die korrekte Zuordnung von Entitäten und Abkürzungen kosteten in der Praxis deutlich mehr Aufwand als der eigentliche Aufbau der RAG-Pipeline. Ein Teilnehmer löste das Problem uneindeutiger Bezeichner, indem er statt einer klassischen Vektordatenbank einen Knowledge Graph mit Ontologien einsetzte, um Entitäten, Synonyme und Abkürzungen eindeutig zu verknüpfen. Auffällig war zudem, dass die Qualitätssicherung in der Praxis überwiegend manuell erfolgte, etwa über Testfragenkataloge und Daumen-hoch- beziehungsweise Daumen-runter-Bewertungen durch Nutzer, während automatisierte, KI-gestützte Evaluationsmethoden aus der Forschung bislang kaum Eingang in den Unternehmensalltag gefunden haben. Diese Beobachtung deckt sich mit der Empfehlung im vorigen Abschnitt, Golden-Test-Sets und Red-Team-Tests fest im eigenen Evaluationsprozess zu verankern.
Pro und Contra im Überblick
Die folgende Tabelle fasst die wichtigsten Kriterien und ihre praktischen Auswirkungen zusammen.
| Kriterium | RAG | Fine-Tuning |
| Aktualität der Daten | Sehr hoch, Zugriff zur Laufzeit | Niedrig, erfordert neuen Trainingslauf |
| Nachvollziehbarkeit / Quellen | Hoch, Antworten mit Belegen | Gering, kaum Quellenverweise |
| Konsistenter Stil / Tonalität | Mittel, über Prompting steuerbar | Hoch, dauerhaft im Modell verankert |
| Startaufwand und Budget | Niedriger, schnellere Iteration | Höher, trotz LoRA/QLoRA spürbar |
| Laufende Kosten | Retrieval, Vektor-DB, Tokenverbrauch | Seltener Retraining-Aufwand |
| Sicherheitsrisiko | Prompt Injection über Dokumente | Geringere externe Angriffsfläche |
| Datenschutz / Datenhoheit | Vektordatenbank braucht Kontrolle | Wissen indirekt in Gewichten |
| Geeignet für | Dynamisches Fachwissen, Compliance | Stabiles Vokabular, feste Formate |
Tabelle 1: Kriterienvergleich RAG versus Fine-Tuning für den Enterprise-Einsatz. Eigene redaktionelle Zusammenstellung auf Basis der im Text zitierten Quellen.
Hybrid-Architekturen werden zum Standard
Die Analystenmeinungen und die Zahlen aus der Praxis zeichnen ein konsistentes Bild: RAG ist für die meisten wissensintensiven Anwendungsfälle der pragmatischere Einstieg, während Fine-Tuning seine Stärken dort ausspielt, wo es um Verhalten, Format oder ein sehr enges Fachvokabular geht. In der Praxis schließen sich beide Ansätze zunehmend nicht aus, sondern ergänzen sich: Ein leichtgewichtig feinjustiertes Modell für Ton und Struktur wird mit einer RAG-Pipeline für aktuelles Fachwissen kombiniert. Dieses Muster liefert zitierfähige, markenkonforme und gleichzeitig aktuelle Antworten und wird von Forrester als natürliche Weiterentwicklung von RAG in Richtung agentenbasierter Automatisierung beschrieben.
Handlungsempfehlung für die Praxis
Für IT-Verantwortliche, die vor dieser Entscheidung stehen, lassen sich aus den genannten Quellen vier praktische Leitplanken ableiten.
- Mit RAG starten, wenn Daten sich häufig ändern, Quellenverweise gefordert sind oder Budget und Zeit für wiederkehrende Trainingszyklen fehlen.
- Fine-Tuning gezielt ergänzen, wenn Tonalität, Format oder ein sehr stabiles Fachvokabular im Vordergrund stehen und ausreichend saubere Trainingsdaten vorliegen.
- Sicherheitsanforderungen aus EU AI Act und DSGVO von Anfang an mitplanen, insbesondere Zugriffskontrollen auf die Vektordatenbank und Schutz vor Prompt Injection.
- Kosten über den gesamten Lebenszyklus rechnen, nicht nur den ersten Trainingslauf oder die erste Integration der Wissensbasis.
Der Mehrwert dieser erweiterten Betrachtung liegt darin, die Entscheidung nicht allein technisch, sondern auch unter Sicherheits-, Kosten- und Compliance-Gesichtspunkten zu treffen, denn genau diese Faktoren entscheiden in der Praxis häufiger über den Projekterfolg als die reine Modellwahl.
Fragen und Antworten zu RAG und Fine-Tuning
Ist RAG immer die bessere Wahl gegenüber Fine-Tuning?
Nein. RAG ist für die meisten wissensintensiven Anwendungsfälle mit häufig wechselnden Daten die pragmatischere Lösung, wie es auch der Menlo-Ventures-Trend von 51 zu 9 Prozent Marktanteil bei produktiven Architekturen nahelegt. Bei sehr stabilem Fachvokabular, festen Formaten oder konsistenter Markenstimme kann Fine-Tuning jedoch die passendere Ergänzung sein.
Kann man RAG und Fine-Tuning gleichzeitig einsetzen?
Ja, diese Kombination gilt inzwischen als gängiges Muster: Ein feinjustiertes Modell für Stil und Format wird mit einer RAG-Pipeline für aktuelles, belegbares Fachwissen verbunden.
Welche Sicherheitsrisiken sind bei RAG besonders zu beachten?
KuppingerCole verweist vor allem auf Prompt Injection über manipulierte Dokumente sowie auf unbeabsichtigten Datenabfluss aus der Vektordatenbank. Zugriffskontrollen auf die Wissensbasis sind daher ebenso wichtig wie die Absicherung des Modells selbst.
Wie wirkt sich der EU AI Act auf die Entscheidung aus?
Eine dokumentierte Quellenkette, wie sie RAG-Systeme liefern können, erleichtert Nachweispflichten. Unabhängig von der gewählten Technik sollten Unternehmen jedoch frühzeitig prüfen, in welche Risikokategorie ihr konkreter Anwendungsfall fällt.
Reduziert RAG Halluzinationen zuverlässig?
RAG verringert das Risiko, weil Antworten auf abgerufenen Dokumenten basieren, ersetzt aber keine eigene Evaluierung. Eine allgemeingültige, seriös belegte Prozentzahl für die Reduktion gibt es nicht, sie hängt stark von Datenqualität und Retrieval-Logik im Einzelfall ab.
Wie weit sind Unternehmen im DACH-Raum mit RAG in der Praxis wirklich?
Laut der Innsbrucker Interviewstudie befanden sich zwölf von dreizehn untersuchten Systemen im Jahr 2025 noch unterhalb von Technology Readiness Level 7, also im Prototypen- oder Pilotstadium. Die größte Hürde war durchweg die Datenaufbereitung, nicht die Modellwahl selbst.