Mit dem Pentest-Framework ARTEX, DeepSeek, GLM, Grok und Coding-Assistenten griff ein Akteur Organisationen in über 15 Ländern an. Ziel waren Finanzdaten.
Modelle prüfen sich gegenseitig
Finanzdaten abgegriffen: Angreifer koordinieren mehrere KI-Modelle
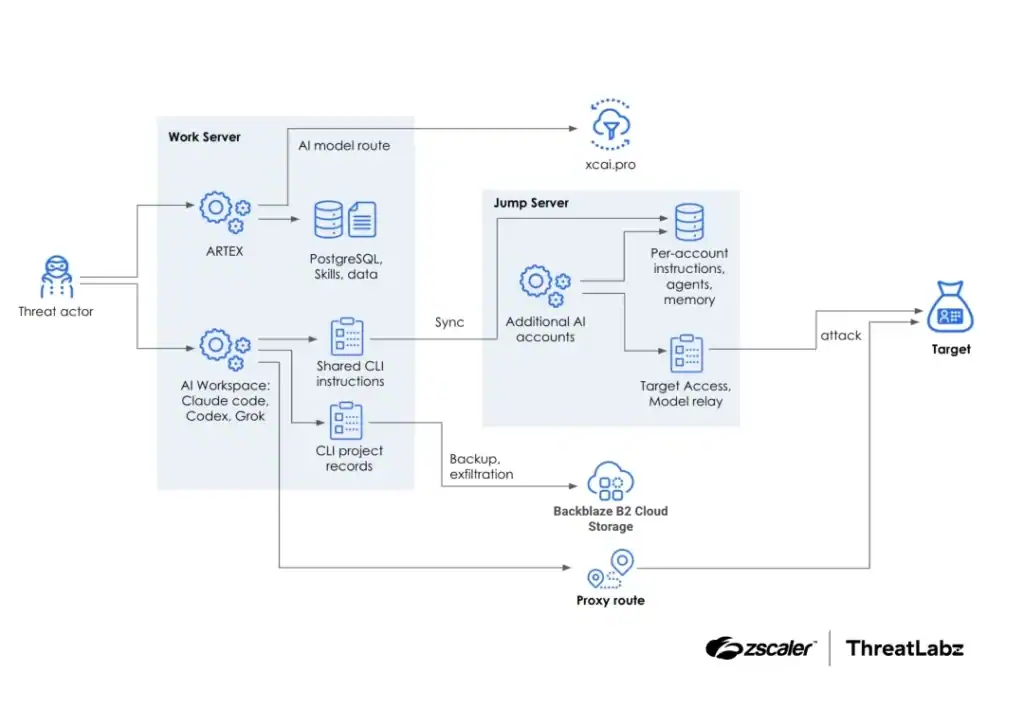
Das Forschungsteam ThreatLabz des Sicherheitsanbieters Zscaler hat eine Angriffskampagne analysiert, bei der ein Akteur mehrere KI-Systeme kombinierte, um Angriffe weltweit zu koordinieren und teilweise zu automatisieren. Eingesetzt wurde dabei das KI-gestützte Framework für Penetrationstests ARTEX zusammen mit eigenen Automatisierungsskripten und verschiedenen KI-Assistenten, darunter Claude Code, Codex und Grok.
Über Südkorea hinaus
Bekannt geworden waren zunächst Angriffe auf Finanzinstitute in Südkorea. Laut Zscaler reicht die Kampagne jedoch deutlich weiter. Die aufgezeichneten Eingaben an die KI-Modelle enthielten Anfragen zur Untersuchung von Organisationen in mehr als 15 Ländern. Ziele waren neben Banken auch Dating-Apps, SMS-Anbieter sowie Plattformen für Kryptowährungen und Zahlungen. Zscaler wertet das Vorgehen als opportunistisch.
Die Eingaben zeigen ein besonderes Interesse an personenbezogenen Daten, Mobilfunknummern und Daten zu Finanztransaktionen sowie Fragen zum Verkauf erbeuteter Datensätze. Zscaler geht deshalb von finanziellen Motiven aus. Um nicht entdeckt zu werden, wies der Akteur die KI-Modelle an, keine direkten Abhebungen von Konten auszulösen, da unberechtigte Transaktionen Warnungen auslösen und Spuren hinterlassen könnten. Sprache, angegebene Telefonnummern und Anfragen nach Übersetzungen ins Chinesische deuten laut Zscaler stark auf einen chinesischsprachigen Betreiber hin.
Modelle prüfen sich gegenseitig
ARTEX arbeitet mit einer Architektur aus Planer und ausführenden Agenten. Ein Betreiber legt ein Ziel fest, die Agenten zerlegen es in Einzelaufgaben, führen diese mit Werkzeugen aus und dokumentieren die Ergebnisse. Der Akteur verteilte unterschiedliche Rollen auf verschiedene Modelle: DeepSeek übernahm die erste Untersuchung, GLM prüfte die Ergebnisse und die Arbeit spezialisierter Unteragenten auf Lücken und erhielt später zusätzliche Aufgaben. Grok wurde für umfangreiche Recherchen eingesetzt, deren Ergebnisse andere KI-Sitzungen überprüften. Spezialisierte Agenten untersuchten unter anderem Programmierschnittstellen, Quellcode und Android-Apps. Welche Modelle in den einzelnen Sitzungen tatsächlich liefen, konnte Zscaler nicht in allen Fällen unabhängig bestätigen.
Für jede Untersuchung legte ein Skript einen eigenen Ordner mit Dateien zu Zielen, Fortschritt, Notizen, Schwachstellenberichten und Belegen an. So konnten KI-Assistenten Untersuchungen in späteren Sitzungen fortsetzen. Einige Konfigurationen erlaubten es den Agenten, ohne Freigabe jedes einzelnen Schritts zu handeln.
Zscaler empfiehlt eine Zero-Trust-Architektur, die die Angriffsfläche im Internet verringert und Zugriffe nach dem Prinzip der geringsten Rechte vergibt. Bereits im Oktober hatte TrendAI berichtet, dass staatliche Hackergruppen KI-Modelle zunehmend über mehrere Anbieter hinweg nutzen und bei Problemen mit einem Modell auf andere ausweichen.
(red/Zscaler)