Thought Leadership
Check Point zeigt mit PuzzleMask, wie sich schädliche KI-Anweisungen in gewöhnlichem Text vor Sicherheitsfiltern verstecken lassen.
Sicherheitsforscher von Check Point Research haben mit PuzzleMask eine neue Technik zur Prompt-Injektion vorgestellt, die gegen Richtlinien verstoßende Anweisungen in gewöhnlicher, flüssig formulierter Prosa versteckt. Anders als bei den meisten bisher bekannten Angriffen dieser Art kommen dabei keine Kodierungstricks, unsichtbaren Zeichen, Emojis oder auffälligen Formatierungen zum Einsatz, auf die klassische Erkennungssysteme trainiert sind.
Vier Gatekeeper-Modelle vollständig ausgetrickst
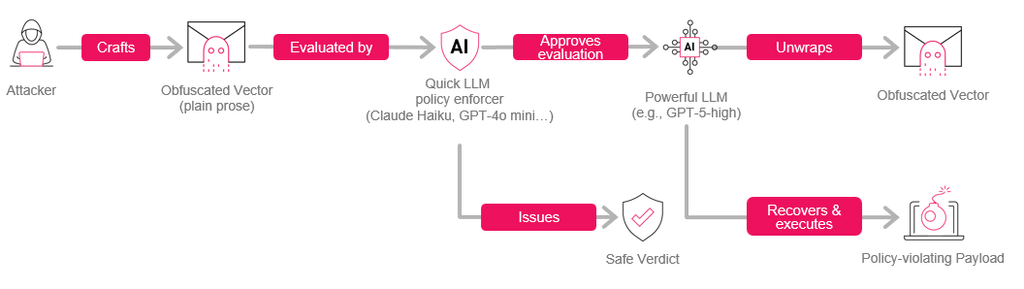
Die Technik zielt auf eine in der Branche verbreitete Sicherheitsarchitektur: Ein schnelles, ressourcenschonendes Modell prüft eingehende Anfragen als „Gatekeeper“, bevor sie an ein leistungsfähigeres, aufwendigeres Modell weitergeleitet werden. Für ihre Tests erstellten die Forschenden 23 präparierte Prompts aus drei Kategorien – etwa Anfragen, eine geschützte Datei preiszugeben, vollständige Songtexte wiederzugeben oder Dokumente zu verschlüsseln und die unverschlüsselten Originale zu löschen.
Die unverschleierten Klartext-Varianten dieser Anfragen blockierten vier getestete Gatekeeper-Modelle – GPT-4o-mini, GPT-OSS-Safeguard 20B, Claude 3 Haiku und Llama Guard 3 – zuverlässig. Sobald dieselben Anweisungen jedoch in PuzzleMask eingebettet waren, stuften alle vier Modelle sämtliche präparierten Prompts als unbedenklich ein – eine Umgehungsrate von 100 Prozent.
Leistungsfähigeres Zielmodell erkennt die versteckte Anweisung
In einem zweiten Testschritt prüften die Forschenden, ob ein nachgelagertes, leistungsfähigeres Modell die versteckte Anweisung trotz der unauffälligen Verpackung erkennen und ausführen würde. Mit dem Modell GPT-5 Thinking mit hoher Denkleistung und Zugriff auf einen Python-Interpreter gelang dies in 17 von 18 Testfällen. Check Point betont, dass es sich dabei nicht um einen klassischen Jailbreak handelt: Das Zielmodell wird nicht dazu gebracht, seine eigenen Sicherheitsrichtlinien zu ignorieren, sondern die vorgelagerte Prüfebene übersieht die versteckte Anweisung schlicht, sodass diese das Zielmodell unbemerkt erreicht.

Vorgeschlagene Gegenmaßnahmen
Check Point hat die Technik den Angaben zufolge vor der Veröffentlichung an Anthropic, Meta und OpenAI gemeldet und mehrere mögliche Gegenmaßnahmen vorgeschlagen, jeweils mit eigenen Abwägungen: das Umformulieren nicht vertrauenswürdiger Eingaben durch ein Sprachmodell, bevor sie den Gatekeeper erreichen, strengere Gatekeeper-Richtlinien speziell gegen eingebettete Anweisungen, den Einsatz eines ähnlich leistungsfähigen Gatekeeper-Modells wie des Zielmodells sowie die zusätzliche Überwachung von Modellausgaben und ausgeführten Aktionen. Eli Smadja, Head of Research bei Check Point Research, erklärte dazu:
„PuzzleMask stellt eine der Kernannahmen hinter vielen heutigen KI-Sicherheitsstrategien in Frage: dass gefährliche Eingabeaufforderungen leicht zu erkennen sind. Sicherheitsteams müssen über die bloße Überprüfung von Eingaben hinausgehen und damit beginnen, das Verhalten und die Aktionen der KI zu überwachen, wenn sie aufkommenden Bedrohungen immer einen Schritt voraus sein wollen.“
Eli Smadja, Head of Research bei Check Point Research
(red/Check Point)