Ein Außenscan von 454 KI-gebauten Web-Apps zeigt, wo die Lücken liegen: 98 Prozent liefern keine Content-Security-Policy aus. Was Auftraggeber vor dem Go-live verlangen sollten.
Vibe Coding: KI-Web-Apps sicher abnehmen
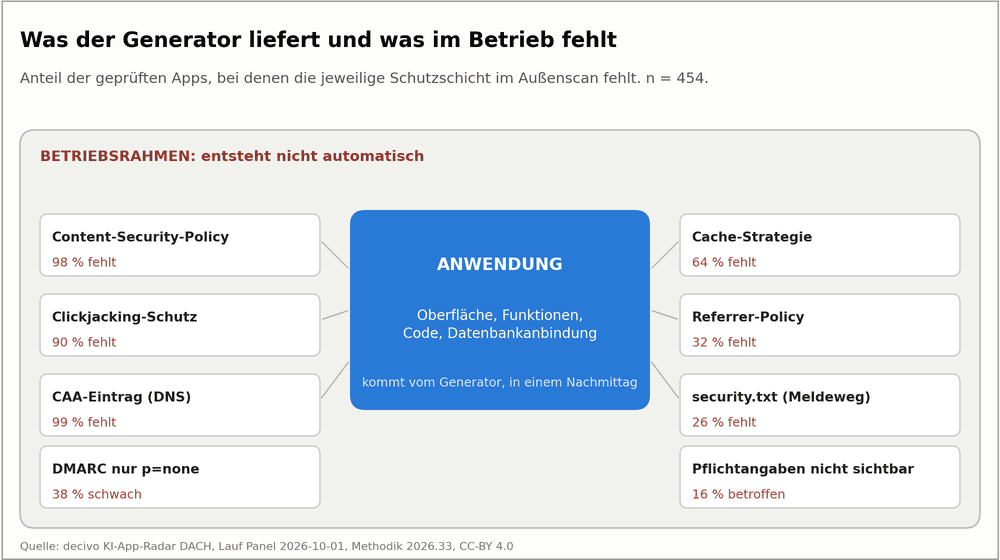
Vibe Coding liefert Web-Apps in einem Nachmittag, aber selten betriebsreife. Ein Außenscan von 454 KI-gebauten Anwendungen im DACH-Raum zeigt: 98 Prozent senden keine Content-Security-Policy, mehr als im Web insgesamt und weit mehr als bei gepflegten Websites. Nur 18 Prozent gelten als produktionsreif. Es fehlt nicht der Code, sondern der Betriebsrahmen. Der Beitrag liefert eine Abnahme-Checkliste, die sich ohne Quellcode-Zugang prüfen lässt.
Das Wichtigste in Kürze
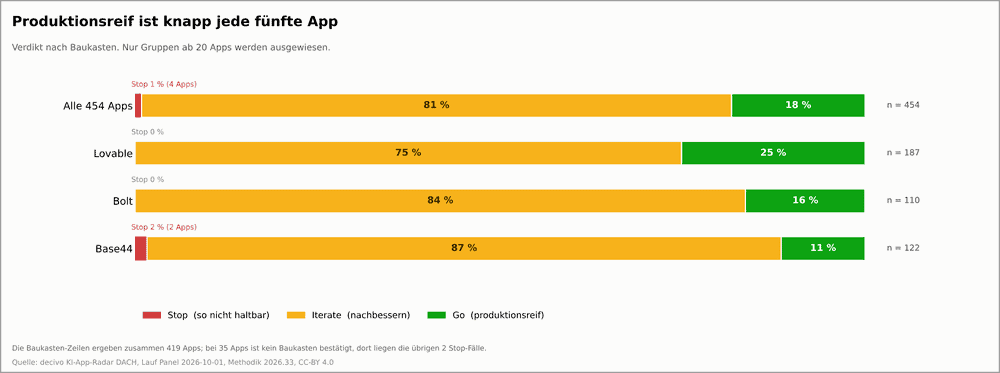
- 98 Prozent der 454 geprüften KI-gebauten Web-Apps liefern keine Content-Security-Policy aus, nur 18 Prozent gelten als produktionsreif.
- Schutz-Header sind im Web generell selten. KI-Apps setzen sie noch seltener als der Durchschnitt und weit seltener als gepflegte Websites.
- Es fehlt selten der Code, sondern der Betriebsrahmen: Header, Zugriffsregeln, Einwilligung, Meldewege.
- Datenschutz und Barrierefreiheit schlagen breiter an als die Technik: 76 Prozent zeigen Barrierefreiheits-Verstöße, 33 Prozent kontaktieren zur Laufzeit drei oder mehr fremde Dienste.
- Die Abnahme-Checkliste lässt sich ohne Quellcode-Zugang prüfen und vertraglich verlangen.
Außenscan von KI-gebauten Web-Apps: Methode und Grenzen
Als KI-gebaute Web-App gilt hier eine öffentlich erreichbare Anwendung, die mit einem KI-Baukasten wie Lovable, Bolt oder Base44 erzeugt wurde. Im Branchenjargon heißt das Vorgehen oft Vibe Coding: Software entsteht per Anweisung in natürlicher Sprache. Welche Schwachstellen dabei im Code selbst entstehen können, zeigt die it-daily-Analyse „Vibe Coding: Der blinde Fleck der KI“.
So entsteht die Stichprobe
Wir messen die auffindbare Population KI-gebauter Web-Apps mit DACH-Bezug in regelmäßigen Läufen. Der Lauf vom Oktober 2026 (Panel 2026-10-01) umfasst 454 Apps, 99 Prozent der eingeplanten Ziele waren erreichbar. Aufgenommen wird eine Seite, wenn sie nachweislich ein Skript von Lovable, Bolt oder Base44 lädt und einen DACH-Bezug hat, also die Endung .de, .at oder .ch, deutsche Seitensprache oder ein verlinktes Impressum. Gesucht wird in fünf öffentlichen Quellen: den Verzeichnissen der Baukästen, den Zertifikatsprotokollen der Certificate Transparency, dem Internet Archive, dem Web-Index Common Crawl und dem Scan-Dienst urlscan.io. In diesem Lauf stammen 450 der 454 Ziele aus urlscan.io.
Naheliegend ist die Sorge, die Stichprobe enthalte vor allem Tests und Prototypen. Das ist nicht der Fall: 449 der 454 Apps laufen auf eigener Domain, nur eine auf einer Subdomain des Baukastens, bei vier ist das Ziel nicht mehr gespeichert. Bei 419 Apps hat der Scan den Baukasten selbst bestätigt. Eigene Domain und Impressum sprechen für einen Live-Betrieb, beweisen produktive Nutzung aber nicht.
Passiv gemessen, nicht angegriffen
Der Scan läuft passiv und browser-äquivalent. Er lädt, was jeder Browser beim Aufruf lädt, klickt nichts an, füllt kein Formular aus, legt kein Konto an und rührt keine sensiblen Pfade an. Keine Backend-Sonden, keine Anmeldeversuche. Bei 86 Prozent der Apps lief zusätzlich eine Prüfung im echten Browser, deshalb zählen einige Befunde nur über diese Teilmenge.
Stop, Iterate, Go: So entsteht das Verdikt
Aus den Befunden bildet der Radar ein Verdikt je App. Stop gilt bei mindestens einem beobachteten kritischen Befund. Iterate gilt bei mindestens einem hohen Befund, einem mittleren in Sicherheit oder Datenschutz, der keine reine Härtung ist, oder drei mittleren im selben Bereich. Sonst lautet das Verdikt Go, im Folgenden „produktionsreif“. Fehlende Schutz-Header wie CSP, HSTS, DMARC oder CAA kippen ein Verdikt also nie. Die vier Stop-Fälle der Stichprobe sind ausnahmslos Schlüssel im ausgelieferten Code: dreimal ein Zugangsschlüssel, einmal ein Vollzugriffs-Schlüssel der Datenbank.
Außenblick statt Code-Analyse
Das ist bewusst eine andere Perspektive als die Analyse von Quellcode. Wer Repositories durchsucht, findet Fehler im Code. Wer von außen misst, sieht, was im Betrieb tatsächlich ausgeliefert wird, inklusive aller Konfigurationsentscheidungen, die nach dem Generieren getroffen wurden oder eben nicht. Beide Blickwinkel finden unterschiedliche Dinge, und der zweite ist der, den auch ein Angreifer hat. Wie verbreitet Schwachstellen im generierten Code selbst sind, zeigen Code-Analysen wie die von Armis Labs, über die it-daily.net unter „KI-generierter Code: Versteckte Sicherheitsrisiken“ berichtet hat.
Grenzen der Messung
Zwei Einschränkungen gehören dazu. Erstens sind die Zahlen Anteile über eine Stichprobe und kein Beweis für eine einzelne App. Zweitens misst der Radar, was auffindbar ist: Apps auf eigener Domain ohne Spuren in den genannten Quellen sind untererfasst. Vor jeder neuen Methodik-Version läuft der Scanner außerdem gegen gepflegte Profi-Seiten, zuletzt im September gegen 47 produktive Websites, bei denen sechs Arten von Fehlalarm aufgefallen und behoben wurden. Das ist eine Fehlalarm-Prüfung, kein Vergleichswert. Rohzahlen und Methodik stehen unter CC-BY 4.0 offen im decivo KI-App-Radar, die Zahlen dieses Laufs unter einer festen Adresse.
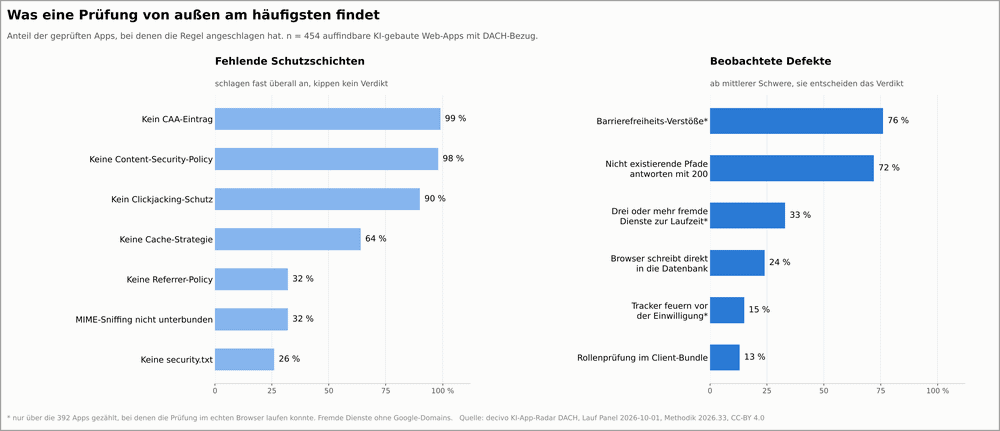
Content-Security-Policy fehlt bei 98 Prozent: Der Lackmustest für KI-Apps
Von allen Befunden ist dieser der unauffälligste und der aussagekräftigste zugleich. Eine Content-Security-Policy (CSP) ist ein HTTP-Header. Er sagt dem Browser, aus welchen Quellen er Skripte, Stylesheets, Bilder und Verbindungen akzeptieren darf. Fehlt er, akzeptiert der Browser alles, was im Dokument steht, ohne Rückfrage.
98 Prozent der geprüften Apps liefern ihn nicht aus. Kein Baukasten setzt ihn standardmäßig, und das ist nachvollziehbar: Eine brauchbare Policy hängt davon ab, welche Fonts, Analysedienste, Zahlungsanbieter und CDNs eine konkrete Anwendung einbindet. Der Generator weiß das nicht. Er kennt die Features, nicht den Betrieb.
Einordnung: KI-Apps im Vergleich zum übrigen Web
Für sich genommen hat diese Zahl allerdings keinen Maßstab, denn auch im übrigen Web ist der Header selten. Nach der Ausgabe 2025 des Web Almanac des HTTP Archive liefern nur 21,9 Prozent der untersuchten Websites überhaupt eine Content-Security-Policy aus, nach 18,5 Prozent im Vorjahr. Rund vier von fünf Seiten verzichten also darauf. Als zweiten Vergleichswert haben wir am 20. Oktober 2026 16 große, professionell gepflegte Websites aus DACH und international mit derselben Messung geprüft (Methodik 2026.35, für diese Regeln identisch mit 2026.33): Bei 5 von 16 fehlte eine wirksame Policy.
Die Gruppe ist klein und bewusst prominent gewählt, ihr Wert ist eine Obergrenze und kein Durchschnitt; einzelne Seiten nennen wir nicht. Die belastbare Aussage lautet deshalb nicht „KI-Apps sind schlecht“, sondern: Schutz-Header sind im Web generell selten, KI-Apps setzen sie noch seltener als der Durchschnitt und deutlich seltener als gepflegte Seiten. Bei Trackern vor der Einwilligung liegen die KI-Apps mit 15 Prozent dagegen sogar etwas besser als die Vergleichsgruppe mit 3 von 15 Seiten, also 20 Prozent (bei einer der 16 Seiten lief die Prüfung im echten Browser nicht, sie fehlt deshalb in diesem Nenner).
Warum generierter Code und strenge Policies kollidieren
Dazu kommt ein handfester Konflikt. Generierter Code arbeitet gern mit eingebetteten Skripten und Inline-Styles, weil das in einem einzelnen Dateiwurf einfacher ist. Eine strenge Policy verbietet genau das. Wer sie nachträglich aktiviert, bricht im Zweifel die eigene Oberfläche und schaltet sie nach zehn Minuten wieder ab. So überlebt der fehlende Header jeden Release. Der gangbare Weg ist eine Policy mit Nonces oder Hashes, die zunächst im Modus Content-Security-Policy-Report-Only mitläuft und Verstöße nur meldet, bis alle legitimen Quellen erfasst sind. Das OWASP Content Security Policy Cheat Sheet beschreibt das Vorgehen Schritt für Schritt.
Was ohne Content-Security-Policy passieren kann: Cross-Site-Scripting im Browser
Die Policy ist kein Schutz gegen eine bestimmte Lücke, sondern eine zweite Linie. Sie wirkt in dem Moment, in dem die erste versagt hat.
Ein Beispiel aus der Mechanik: Eine Anwendung zeigt einen Wert an, der aus einer Nutzereingabe stammt, und filtert ihn nicht sauber. Ein Angreifer schiebt an dieser Stelle ein Skript in die Seite. Fachleute sprechen von Cross-Site-Scripting (XSS). Ohne Policy läuft dieses Skript mit allen Rechten der Seite. Es liest Session-Token, es kann Formularfelder mitlesen, es kann Daten an eine beliebige fremde Adresse senden. Mit einer Policy, die nur eigene Quellen erlaubt, wird derselbe Angriff im Browser gestoppt, bevor etwas abfließt.
Clickjacking, MIME-Sniffing, Referrer: die übrigen Härtungslücken
Dieselbe Logik trägt die übrigen Härtungsbefunde. 90 Prozent der Apps setzen keinen Clickjacking-Schutz (über X-Frame-Options oder die CSP-Direktive frame-ancestors), lassen sich also in einem fremden Rahmen einbetten. 32 Prozent unterbinden MIME-Sniffing nicht (ohne den Header X-Content-Type-Options rät der Browser selbst, welchen Dateityp er vor sich hat), 32 Prozent setzen keine Referrer-Policy (sie steuert, welche Adressinformationen beim Seitenwechsel an Dritte gehen), bei 26 Prozent fehlt eine security.txt und damit eine Adresse, an die jemand eine gefundene Schwachstelle überhaupt melden könnte. Das Format ist seit 2022 als RFC 9116 standardisiert. Einzeln ist jeder dieser Punkte eine Zeile Konfiguration. Zusammen sind sie der Unterschied zwischen einem Vorfall und einem Beinahe-Vorfall.
Architektur- und Datenschutzbefunde: Was der beobachtete Zustand verrät
Interessanter als die fehlenden Schutzschichten sind die Befunde, die einen beobachteten Zustand beschreiben. Die wiegen schwerer, weil sie etwas über die Architektur verraten.
Status 200 für jede Adresse
72 Prozent antworten auf nicht existierende Pfade mit Status 200. Eine erfundene Adresse liefert also die Startseite statt eines 404. Das ist der Normalfall bei einer Single-Page-Anwendung mit Catch-all-Route und zunächst kein Sicherheitsproblem. Es hat trotzdem Folgen: Monitoring erkennt keine kaputten Links mehr, Suchmaschinen indexieren Phantomseiten, und ein Tippfehler in einer internen Verlinkung fällt niemandem auf, weil immer etwas zurückkommt.
Browser schreibt direkt in die Datenbank
24 Prozent schreiben aus dem Browser direkt in die Datenbank. Das ist das typische Muster moderner Backend-Dienste: Der Client hält einen öffentlichen Schlüssel und spricht die Datenbank unmittelbar an. Sauber konfiguriert ist das vollkommen in Ordnung, denn die Zugriffsregeln liegen dann in der Datenbank selbst. Unsauber konfiguriert liegt die Autorisierung faktisch im Browser des Nutzers, also an einem Ort, den der Betreiber nicht kontrolliert. Wie real dieses Risiko ist, zeigte 2025 die Schwachstelle CVE-2025-48757: In 170 mit Lovable erzeugten Projekten fehlten wirksame Row-Level-Security-Regeln in der angebundenen Supabase-Datenbank, Unbefugte konnten Tabellen lesen oder beschreiben. Von außen lässt sich nur sehen, dass das Muster vorliegt, nicht ob die Regeln greifen. Genau deshalb gehört die Frage in jede Abnahme.
Rollenprüfung im Client-Bundle
13 Prozent haben eine Rollenprüfung im ausgelieferten Client-Bundle. Im JavaScript steht lesbar, wer Administrator sein darf. Auch das muss keine Lücke sein, wenn dieselbe Prüfung serverseitig noch einmal stattfindet. Die Erfahrung sagt nur: Wo die Prüfung im Bundle sichtbar ist, ist sie oft die einzige.
Datenschutz: Drittdienste und Tracker
Dazu kommen Datenschutz und Barrierefreiheit, die in der Stichprobe breiter anschlagen als die Technik. 33 Prozent der im Browser geprüften Apps kontaktieren zur Laufzeit mindestens drei fremde Dienste, die typischerweise außerhalb der EU verarbeiten. Google-Domains wie Google Fonts zählt diese Regel nicht mit, obwohl auch extern nachgeladene Schriften heikel sind: Das LG München I sprach 2022 einem Besucher Schadensersatz zu, weil seine IP-Adresse ohne Einwilligung an Google Fonts übertragen wurde (Az. 3 O 17493/20). 16 Prozent binden US-Tracker im ausgelieferten Code ein, 17 Prozent setzen Tracker ohne sichtbare Einwilligungsoberfläche ein, 15 Prozent feuern Tracker bereits vor der Einwilligung, 12 Prozent setzen Tracking-Cookies ohne jede Zustimmung. Das kollidiert direkt mit § 25 TDDDG, der für nicht notwendige Cookies und Tracking eine vorherige Einwilligung verlangt. Bei 16 Prozent sind Pflichtangaben wie Impressum (§ 5 DDG) oder Datenschutzerklärung nicht sichtbar auffindbar.
Barrierefreiheit: 76 Prozent mit Verstößen
76 Prozent der im Browser prüfbaren Apps zeigen Barrierefreiheits-Verstöße im gerenderten Zustand. Geprüft wird mit der Open-Source-Engine axe-core gegen die Stufen A und AA der WCAG; weil automatisierte Regeln nur einen Teil der Kriterien erfassen, ist der Wert eine Untergrenze. Seit am 28. Juni 2025 die Pflichten des Barrierefreiheitsstärkungsgesetzes (BFSG) greifen, ist das für Anbieter verbraucherorientierter Online-Dienste, etwa Shops oder Buchungsstrecken, kein kosmetisches Thema mehr. Ausgenommen sind unter anderem Kleinstunternehmen, die Dienstleistungen erbringen, sowie reine B2B-Angebote.
Lovable, Bolt und Base44 im Vergleich: Drei Muster, die alle Baukästen teilen
Über die Plattformen hinweg sieht das Bild ähnlich aus. Lovable kommt auf 25 Prozent produktionsreife Apps, Bolt auf 16 Prozent, Base44 auf 11 Prozent. Die Unterschiede sind vorhanden, aber klein gegen das, was alle drei gemeinsam haben.
Fehlender statt falscher Schutz
Die auffälligen Befunde sind fast durchweg Abwesenheiten. Ein Header ist nicht gesetzt, eine Regel ist nicht definiert, eine Prüfung findet nicht statt. Statische Codeanalyse ist darauf schlecht geeicht, weil sie Muster findet, die da sind, nicht Schutzmaßnahmen, die fehlen.
Der Generator endet am Rand der Anwendung
Header, DNS-Einträge, E-Mail-Absicherung, Caching, Einwilligungsverwaltung: Das sind Betriebsentscheidungen. Wer kein Team hat, das sie trifft, hat sie nicht getroffen. 99 Prozent ohne CAA-Eintrag (er legt fest, welche Stellen Zertifikate für die Domain ausstellen dürfen) und 38 Prozent mit einem zahnlosen DMARC auf p=none (gefälschte Absender werden erkannt, aber nicht abgewiesen) sind derselbe Befund in anderer Kleidung.
„Läuft“ ist das falsche Abnahmekriterium
Eine generierte Anwendung funktioniert sehr früh sehr überzeugend. Die Demo klickt sich durch, das Layout sitzt, der erste Nutzer kommt rein. Was fehlt, sieht man dem laufenden System nicht an, und genau das macht den Zeitpunkt der Abnahme so heikel.
Alle Befunde nach Schwere im Überblick
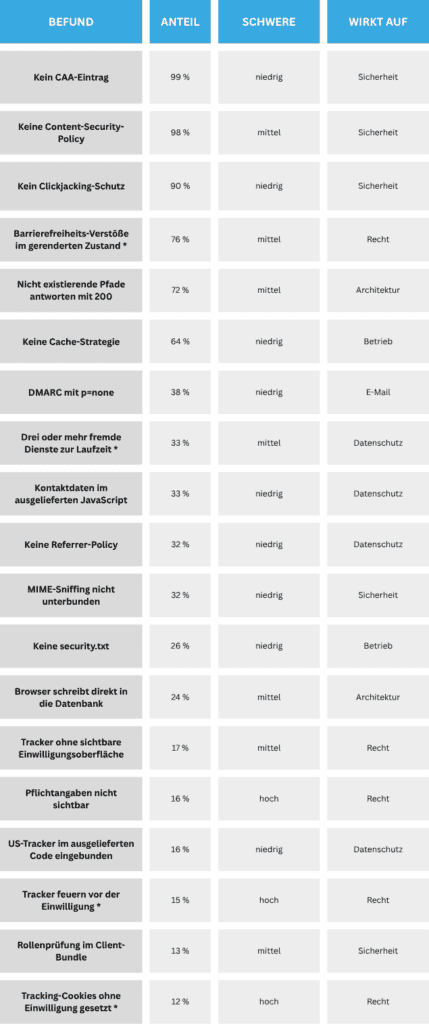
Tabelle 1: Befundhäufigkeit, n = 454. (Quelle: decivo KI-App-Radar DACH, Lauf Panel 2026-10-01.)
Abnahme-Checkliste für KI-gebaute Web-Apps: Was Auftraggeber verlangen sollten
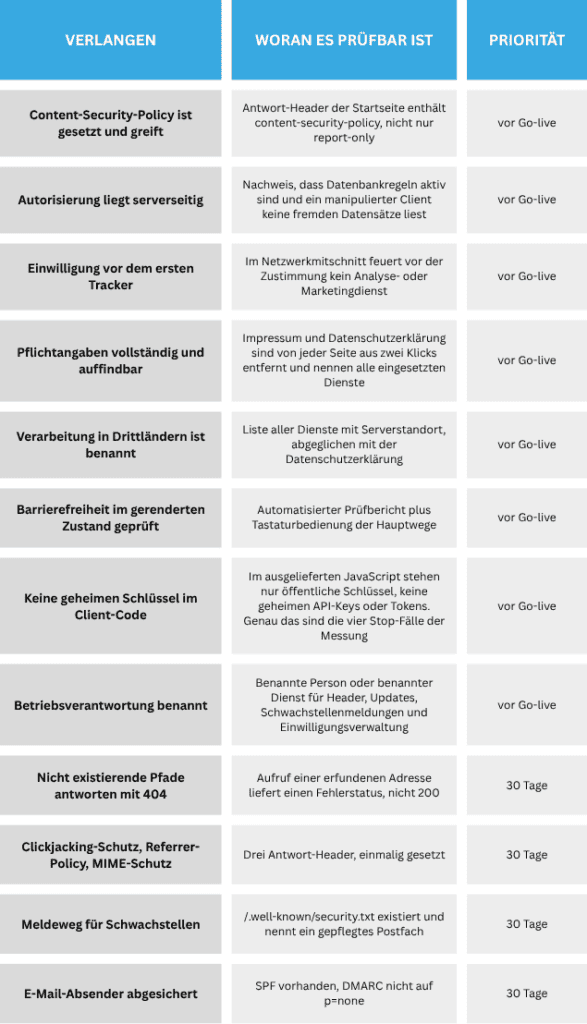
Die praktische Konsequenz aus diesen Zahlen ist keine Werkzeugliste, sondern eine Abnahmeliste. Alle folgenden Punkte lassen sich ohne Zugang zum Code prüfen, von außen, in wenigen Minuten, und sie lassen sich vor der Freigabe vertraglich verlangen.
Aufwand und vertragliche Verankerung
Der Aufwand hinter dieser Liste ist überschaubar. Die meisten Punkte sind Konfiguration, kein Umbau. Teuer wird es nur, wenn sie erst Monate nach dem Start auffallen, weil dann Inhalte, Integrationen und Nutzergewohnheiten daran hängen.
Wer die Liste in die Leistungsbeschreibung oder das Abnahmeprotokoll übernimmt, macht aus einer Empfehlung ein Kriterium: Ohne bestandene Punkte der Priorität „vor Go-live“ gibt es keine Freigabe.
So prüfen Sie die wichtigsten Punkte selbst
Die Antwort-Header der Startseite zeigt der Netzwerk-Tab der Entwicklerwerkzeuge jedes Browsers. Frei verfügbare Dienste wie securityheaders.com oder das MDN HTTP Observatory (vormals Mozilla Observatory) bewerten die wichtigsten Header automatisch. Eine erfundene Adresse hinter der Domain muss einen Fehlerstatus liefern, und unter /.well-known/security.txt sollte ein gepflegter Meldeweg stehen. Ob Tracker vor der Einwilligung feuern, zeigt derselbe Netzwerk-Tab, wenn die Seite erstmals ohne gespeicherte Cookies geladen wird, etwa in einem privaten Browserfenster. Wer Supabase als Backend nutzt, prüft im Dashboard zusätzlich, ob für jede Tabelle Row Level Security aktiv ist und sinnvolle Regeln greifen.
Trend: Von 13 auf 18 Prozent produktionsreif, aber nur ein Hinweis
Im September (Lauf vom 8. September, Methodik 2026.17, n = 478) lag der Anteil produktionsreifer Apps bei 13 Prozent, im Oktober (Panel 2026-10-01, Methodik 2026.33, n = 454) bei 18 Prozent. Der Folgelauf vom 22. Oktober (Methodik 2026.36, n = 442) kommt auf 20 Prozent. Das sieht nach einer Bewegung in die richtige Richtung aus. Belastbar ist es nicht, denn zwischen den Läufen haben sich sowohl die Stichprobe als auch die Methodik-Version geändert, und eine Regel, die in Version 2026.33 anders greift als in 2026.17, verschiebt den Anteil ohne dass sich an einer einzigen App etwas geändert hätte. Jede Zeile im Radar nennt deshalb ihre Methodik-Version. Trends sind Hinweise, keine Beweise, und wer sie anders verkauft, verkauft Zahlen über seinen eigenen Messaufbau.
Was sich über alle Läufe hält, ist die Richtung der Befunde. Die Spitzenwerte wandern kaum. Fehlende Schutzschichten bleiben die Regel, und die Verteilung zwischen den Baukästen bleibt enger, als es die Marketingversprechen der Anbieter nahelegen.
Fazit: Zwischen „es läuft“ und „es kann in Betrieb“
Die ehrlichste Lesart dieser Stichprobe ist nicht, dass KI schlechte Software baut. Sie baut funktionierende Software, schnell, und darin liegt der Fortschritt. Was sie nicht baut, ist der Rahmen, in dem diese Software betrieben werden kann: Header, Zugriffsregeln, Einwilligungen, Meldewege, Nachweise.
Dieser Rahmen war früher implizit da, weil zwischen Idee und Produktivbetrieb Menschen standen, die ihn mitgebracht haben. Heute kann die Strecke in einem Nachmittag zurückgelegt werden, und niemand reicht den Rahmen nach. Die Lücke ist nicht zwischen gutem und schlechtem Code. Sie ist zwischen „es läuft“ und „es kann in Betrieb“.
Das gilt auch für Fachabteilungen, die mit KI-Baukästen selbst Anwendungen erzeugen: Ohne Abnahme und klare Betriebsverantwortung entsteht Schatten-IT mit Haftungsrisiko. Wer das in eine Abnahmeliste übersetzt, schließt sie mit Konfiguration statt mit einem Projekt.
Häufige Fragen zu KI-gebauten Web-Apps
Was bedeutet Vibe Coding?
Der Begriff geht auf den KI-Forscher Andrej Karpathy zurück, der ihn im Februar 2025 prägte. Gemeint ist Softwareentwicklung per Anweisung in natürlicher Sprache: Ein KI-Werkzeug oder Baukasten wie Lovable, Bolt oder Base44 erzeugt den Code, der Mensch beschreibt, prüft und steuert.
Was ist eine Content-Security-Policy und warum fehlt sie bei KI-gebauten Apps?
Sie ist ein HTTP-Header, der dem Browser vorgibt, aus welchen Quellen er Skripte, Stylesheets, Bilder und Verbindungen akzeptiert. Kein Baukasten setzt sie standardmäßig, weil eine brauchbare Policy vom konkreten Betrieb abhängt und strenge Regeln generierten Code mit eingebetteten Skripten und Inline-Styles brechen können.
Sind KI-gebaute Web-Apps grundsätzlich unsicher?
Nein. Die auffälligsten Befunde sind fehlende Schutzschichten, nicht fehlerhafter Code. 18 Prozent der geprüften Apps gelten bereits als produktionsreif. Die Zahlen sind Anteile über eine Stichprobe und kein Urteil über eine einzelne App. Dass auch der generierte Code selbst Schwachstellen mitbringen kann, beschreibt der it-daily-Beitrag „Programmierende KI: Die generierte Gefahr“.
Wie prüfe ich meine App ohne Zugang zum Quellcode?
Alle Punkte der Abnahme-Checkliste lassen sich von außen prüfen: Antwort-Header, Statuscode einer erfundenen Adresse, security.txt, Netzwerkmitschnitt vor der Einwilligung sowie Impressum und Datenschutzerklärung.
Was muss vor dem Go-live erledigt sein, was später?
Vor dem Go-live: Content-Security-Policy, serverseitige Autorisierung, Einwilligung vor dem ersten Tracker, vollständige Pflichtangaben, benannte Drittlandverarbeitung und geprüfte Barrierefreiheit. Innerhalb von 30 Tagen: 404 statt 200, Clickjacking-, Referrer- und MIME-Schutz, security.txt und E-Mail-Absicherung.
Welche Gesetze sind bei KI-gebauten Web-Apps relevant?
Je nach Angebot vor allem die Impressumspflicht nach § 5 DDG, die Einwilligungspflicht für Cookies und Tracking nach § 25 TDDDG, die Informationspflichten und Regeln für Drittlandübermittlungen der DSGVO sowie seit Juni 2025 das BFSG für verbraucherorientierte Online-Dienste. Die Abnahme-Checkliste deckt diese Punkte technisch ab, ersetzt aber keine Rechtsberatung.
Zahlen und Methodik
decivo KI-App-Radar DACH, Lauf Panel 2026-10-01, Methodik 2026.33, n = 454. Zahlen dieses Laufs, Methodik und Vergleichsmessung vom 20.10.2026, Rohdaten als JSON. Veröffentlicht unter CC-BY 4.0 mit der Bitte um Nennung als „decivo KI-App-Radar DACH“. Vergleichswerte Web: HTTP Archive, Web Almanac 2025, Kapitel Security.